Android / On-device Training / GGUF
GGUF Generator
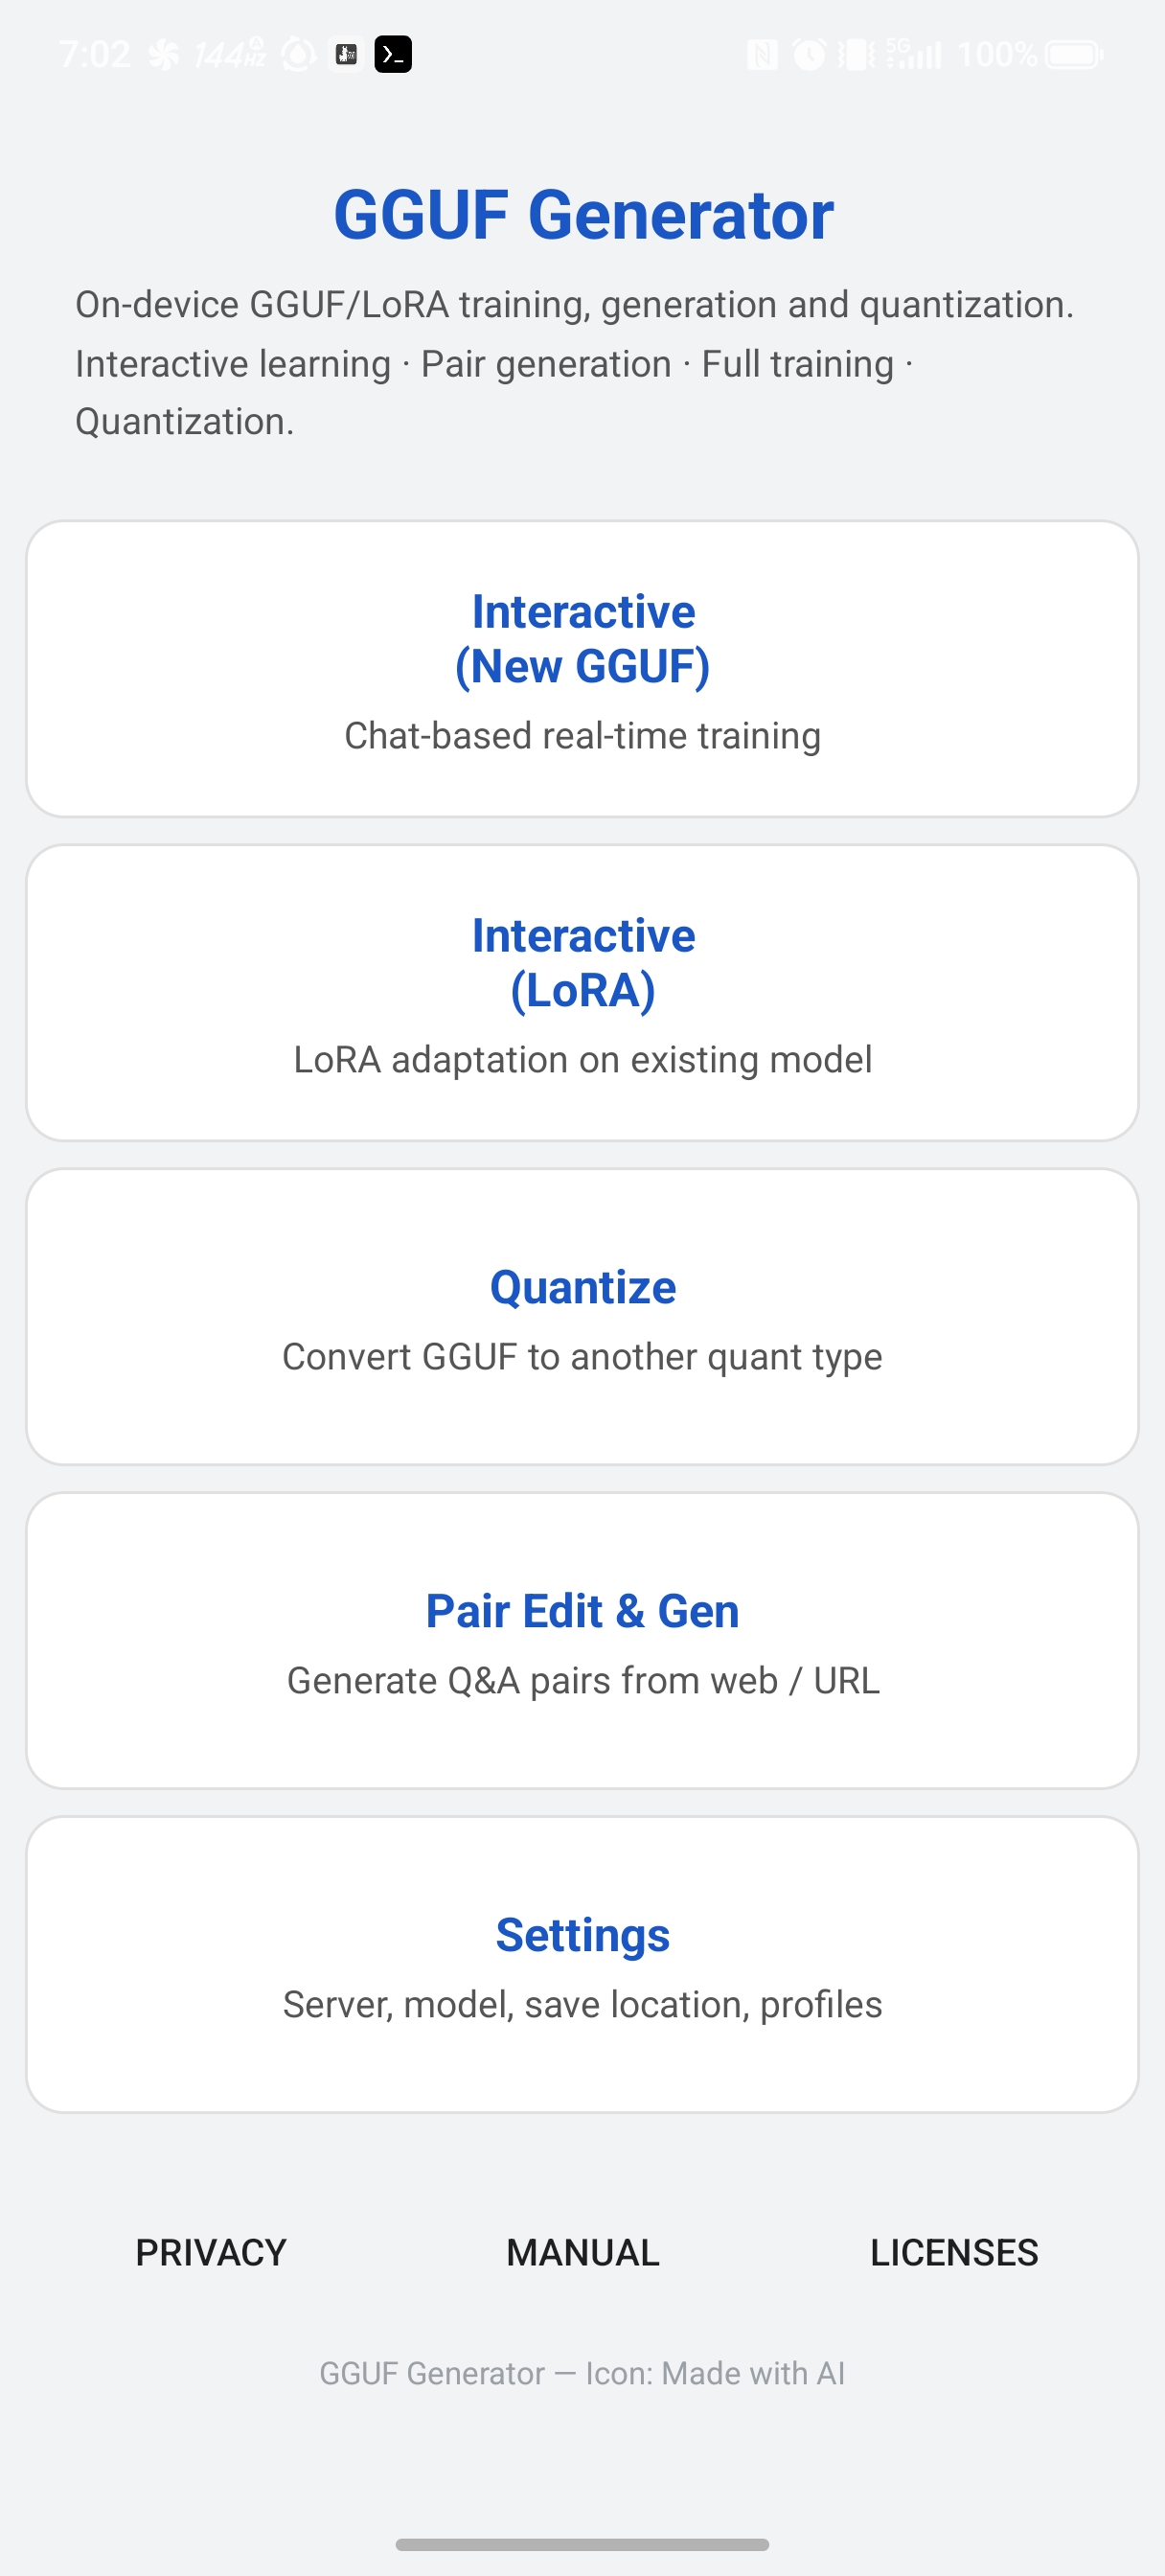
GGUF Generator は、チャット対話による即時学習からデータ自動生成・量子化まで、GGUF モデルのオンデバイス作成・再学習・管理を一つの Android アプリで完結します。インタラクティブモードでは会話の中でモデルをリアルタイムに育て、生成した GGUF はそのまま再ロードして続きの学習が可能です。
文書: 操作マニュアル | Retrainable GGUF について | プライバシーポリシー
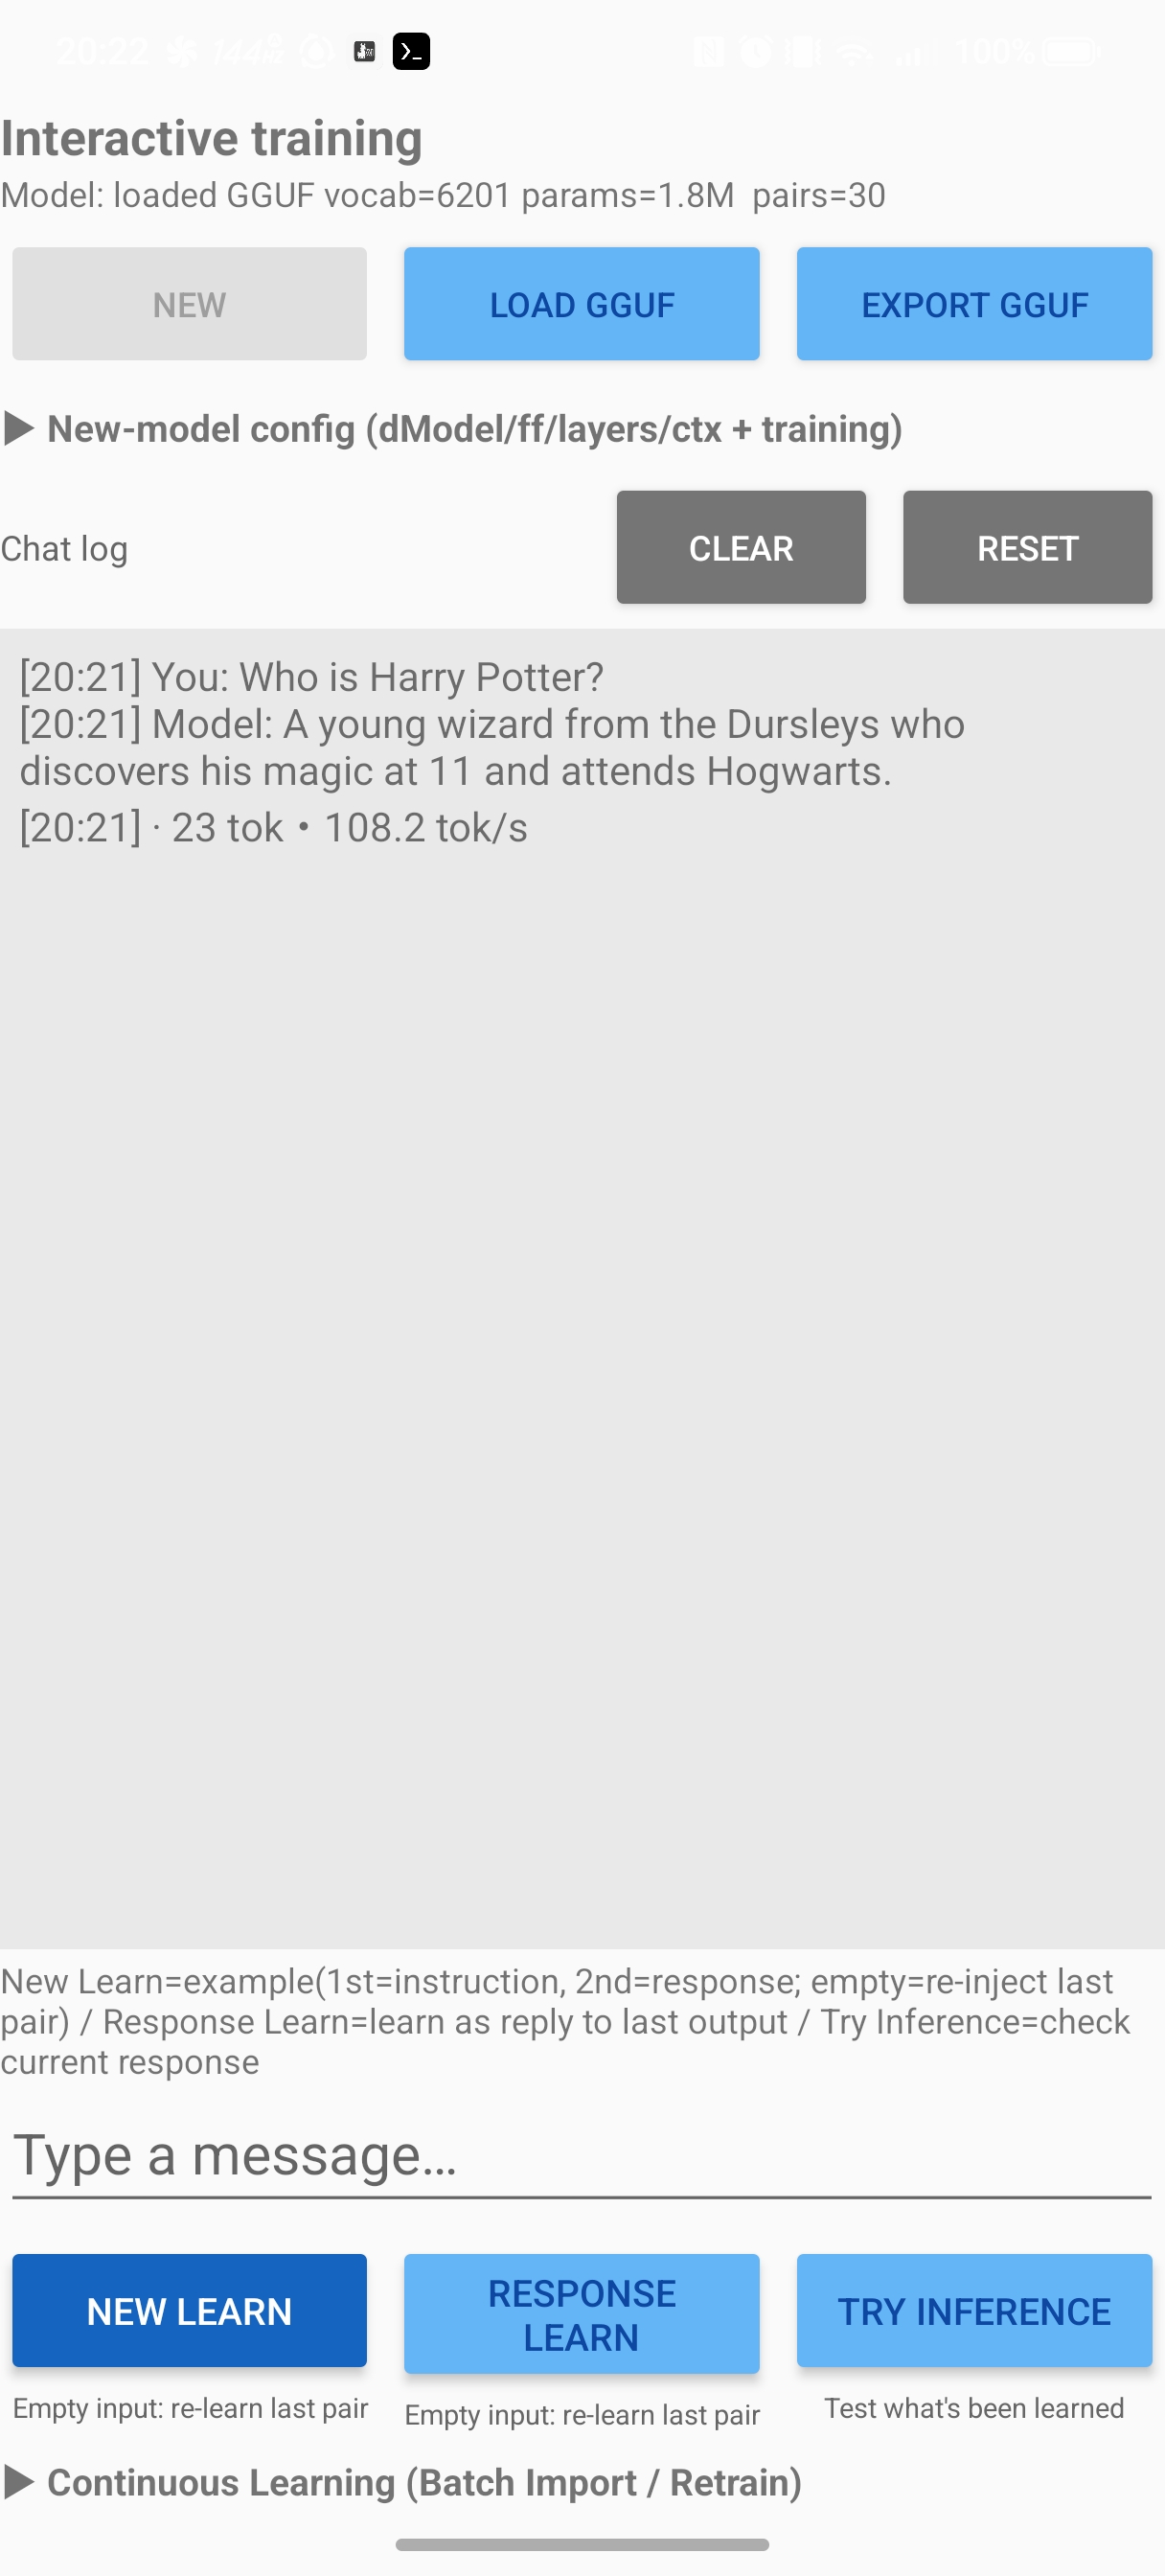
- チャット形式でリアルタイムに学習・確認できる インタラクティブモード(新規 GGUF / LoRA)。
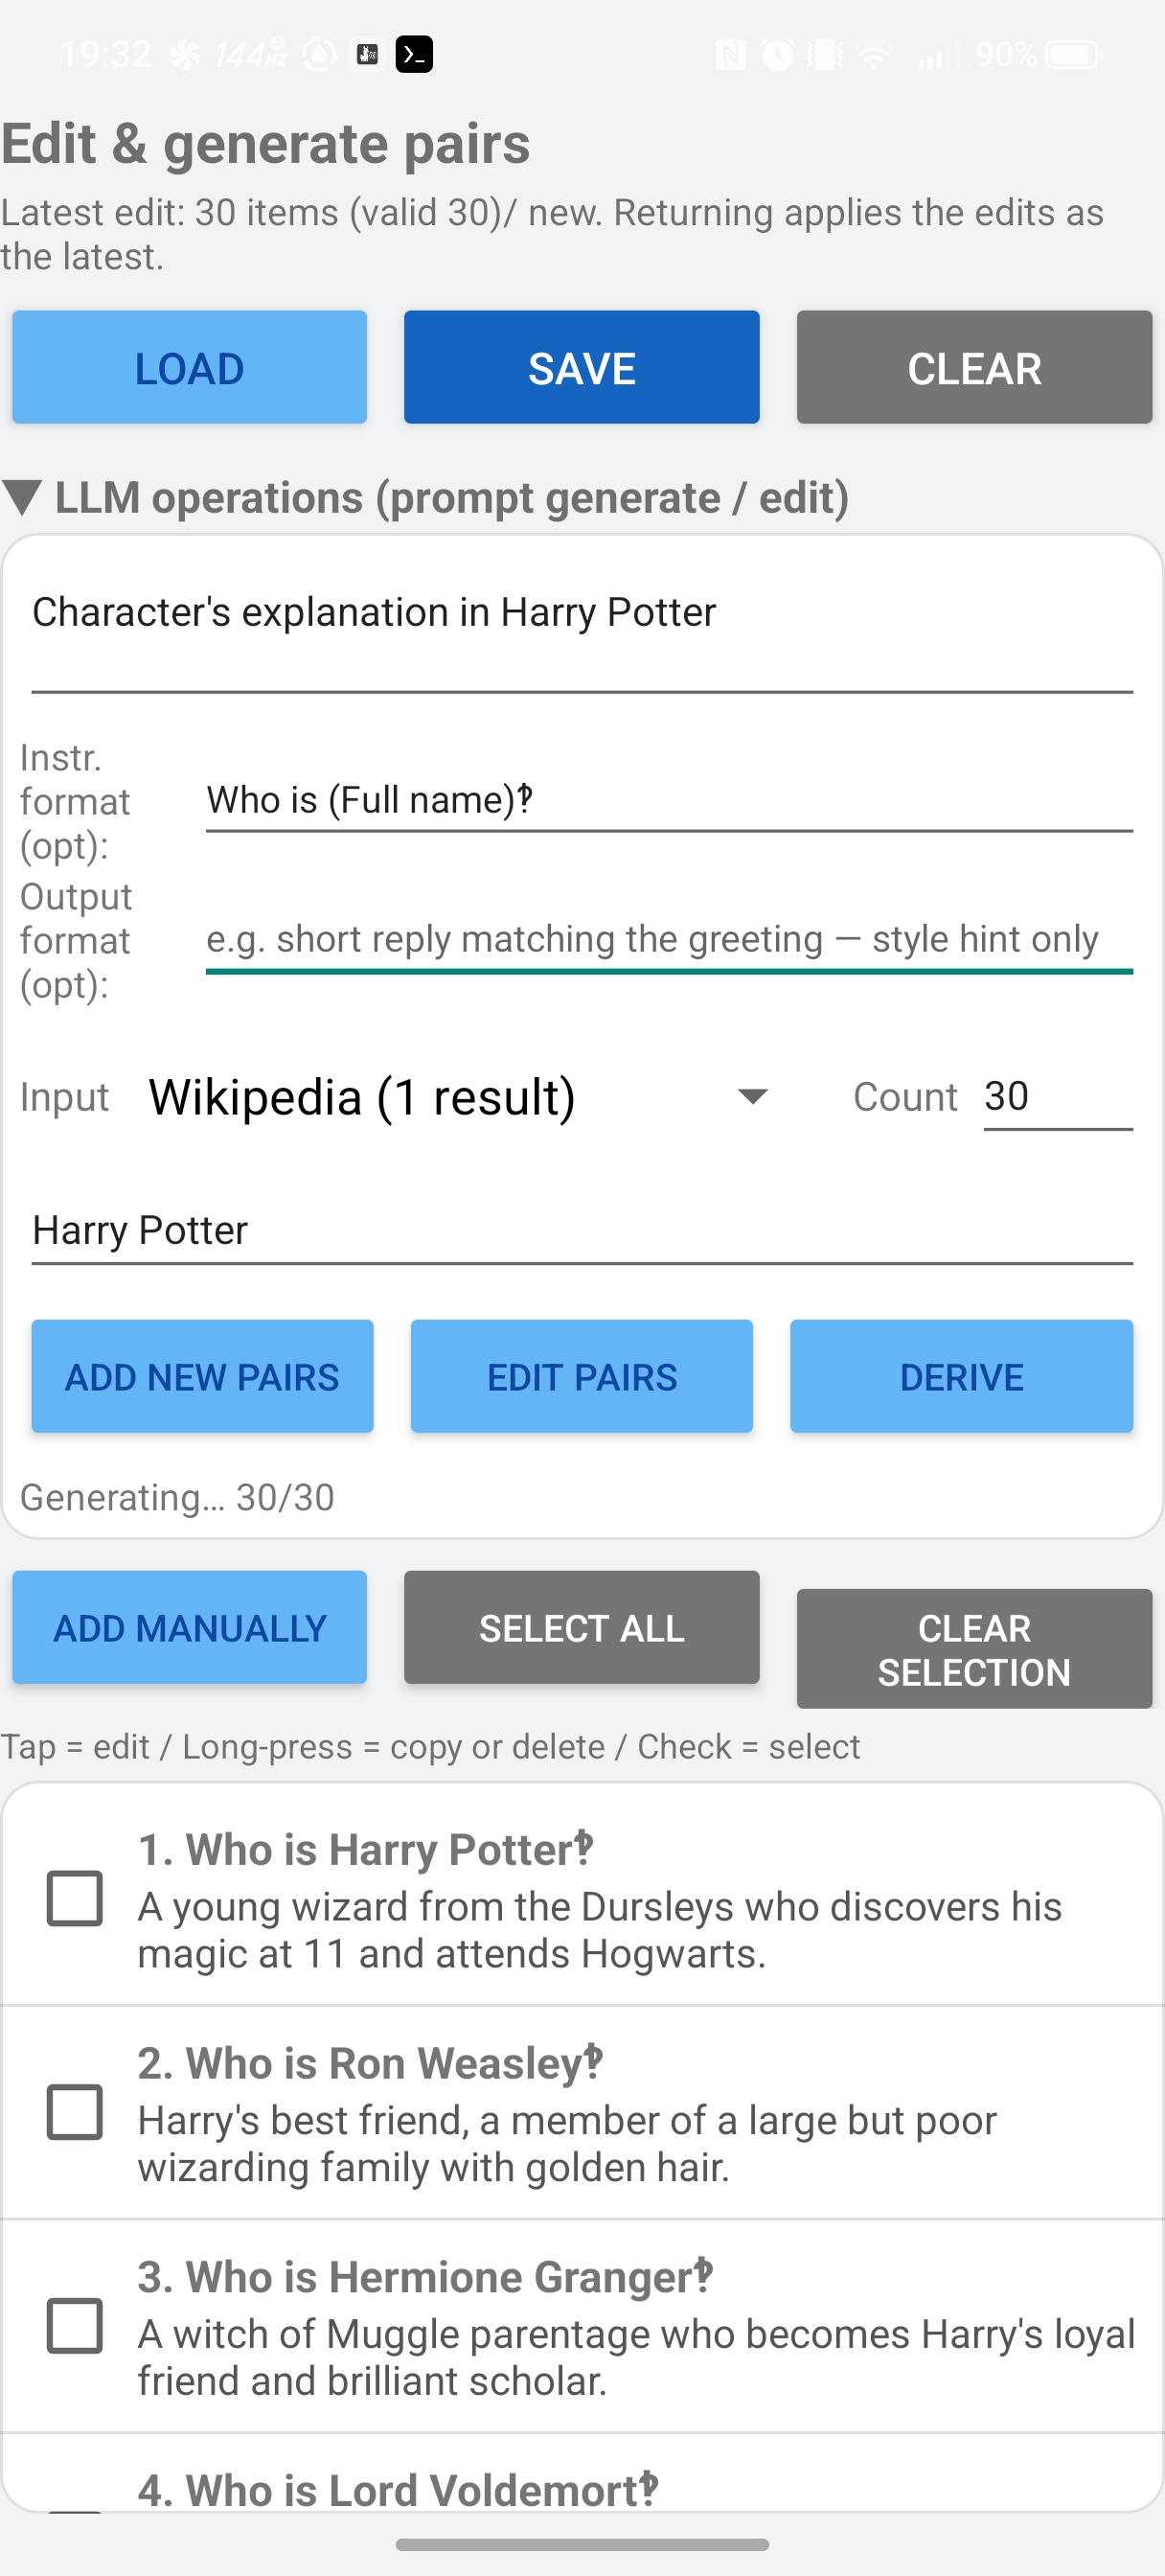
- プロンプト指示で Q/A ペアを新規生成・編集・派生できる ペア編集・生成(入力ソース: 指定 URL / Wikipedia 検索 1 件)。保存したペアはそのまま対話学習へ渡せます。
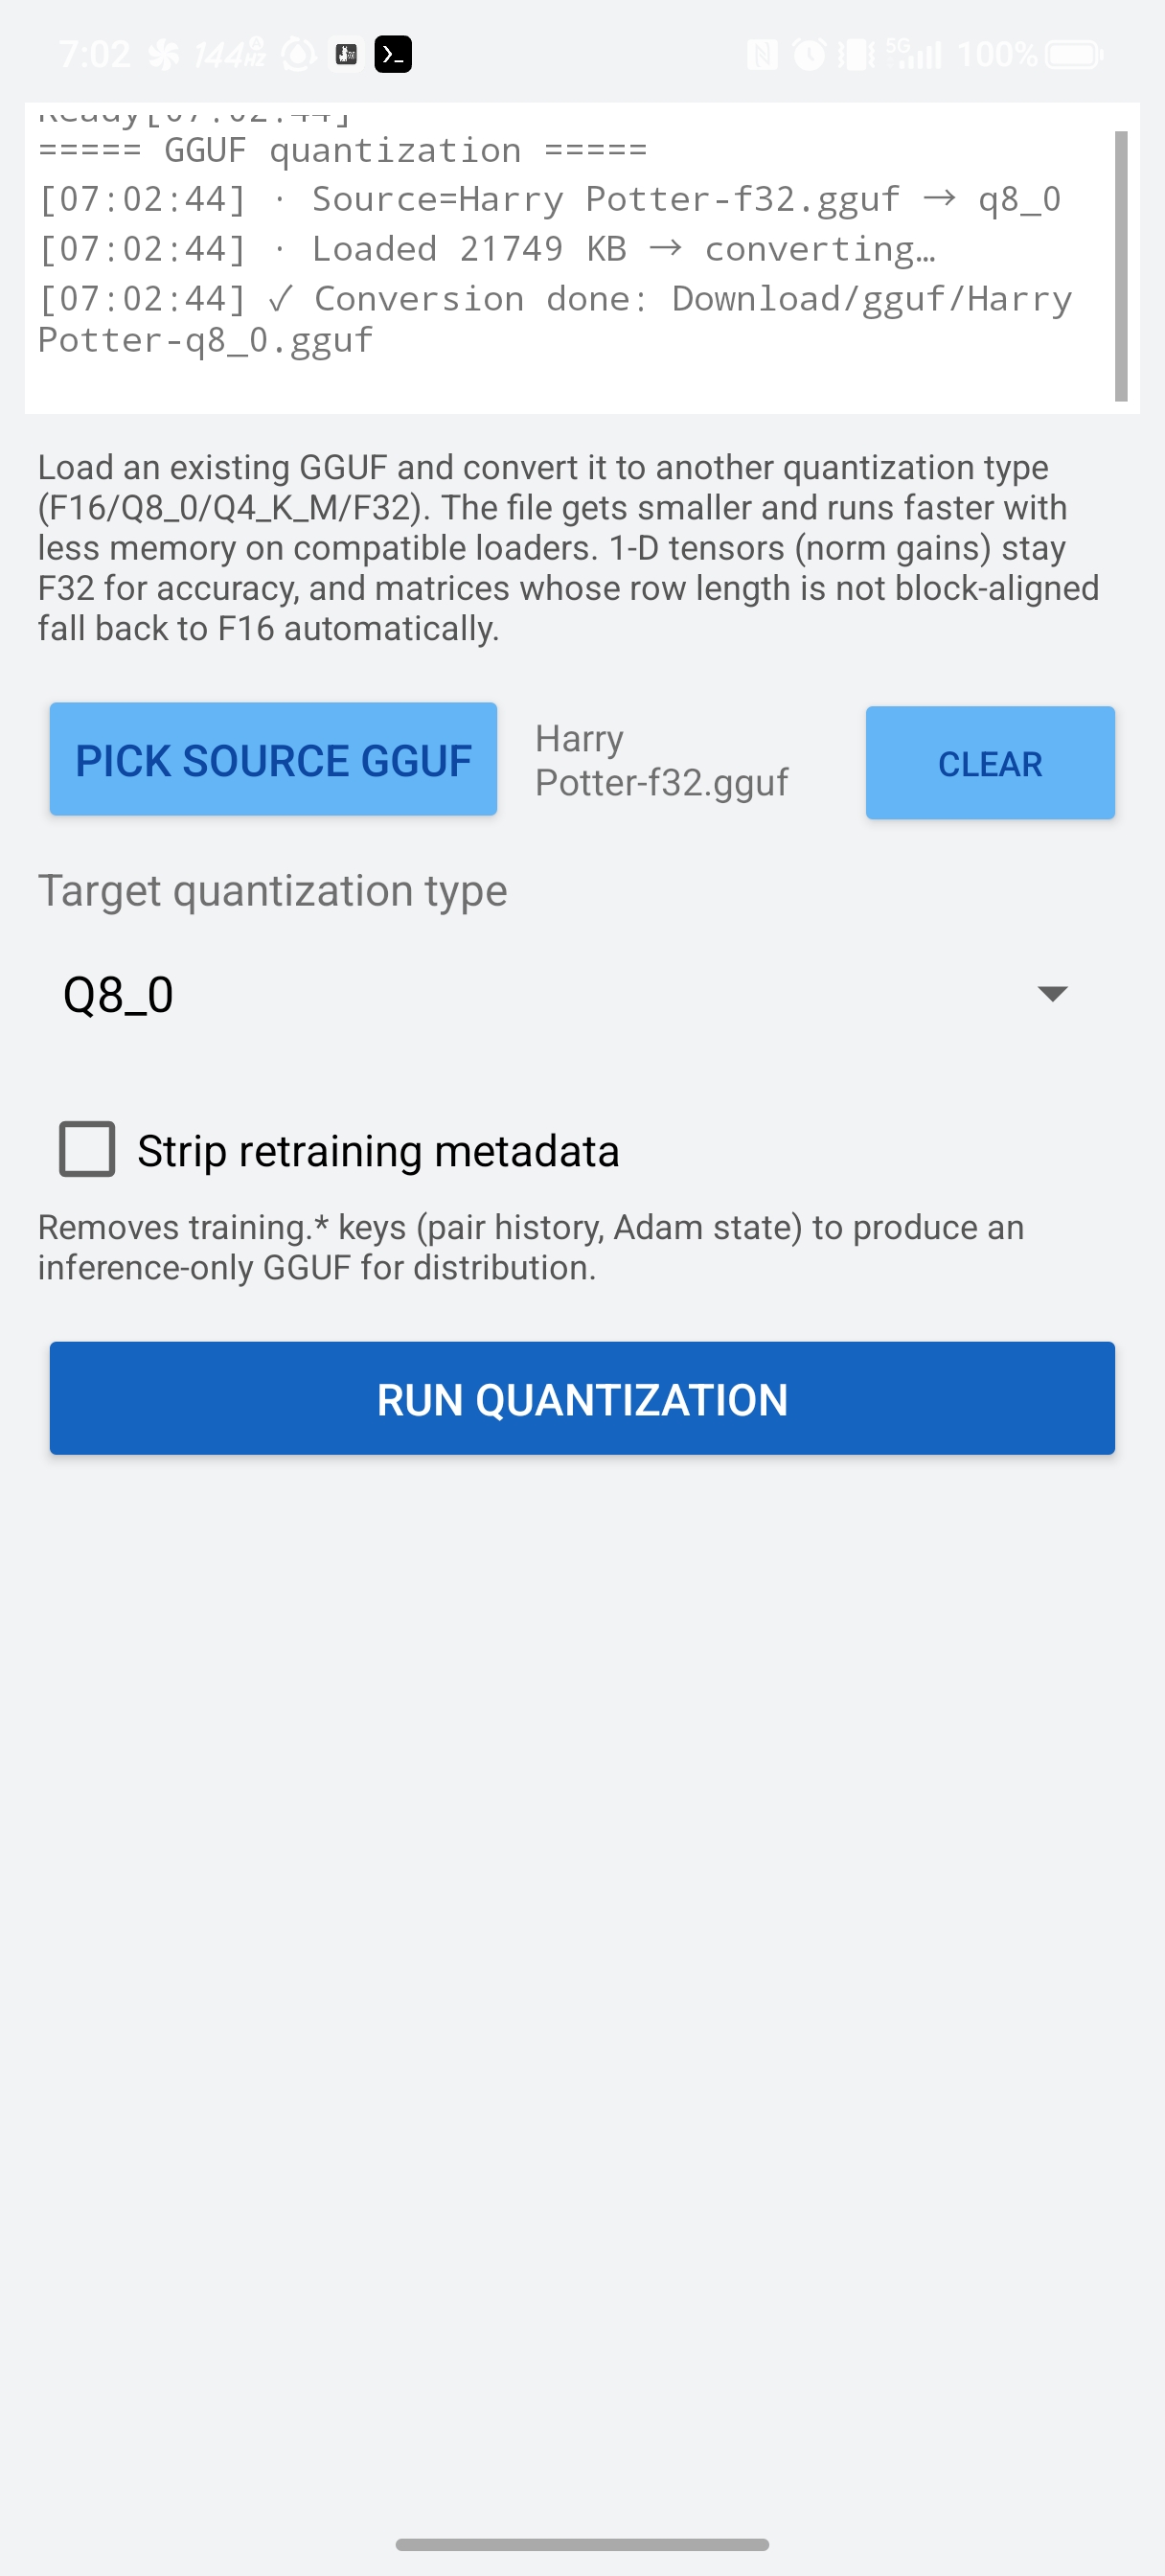
- GGUF を別量子化形式に変換する 量子化変換(F32 / F16 / Q8_0 / Q6_K / Q5_K_M / Q4_K_M / Q2_K など)。学習メタデータを除いた配布用 GGUF の出力も可能。
- 生成した GGUF は再ロードして追加学習が可能な Retrainable GGUF 形式で出力。
スクリーンショット
主な特徴
- インタラクティブ学習(新規 GGUF): NEW LEARN(指示+応答を新規ペアとして学習)/ RESPONSE LEARN(直前の出力への返答として学習)/ TRY INFERENCE(現在のモデルで推論確認)の 3 操作で、チャット画面上でモデルをリアルタイムに育てます。不正解の場合は自動で再注入学習します。LOAD GGUF でセッションを引き継ぎ、EXPORT GGUF で出力します。
- インタラクティブ LoRA: 既存 GGUF(llama / gemma3 / qwen3 / LFM2)へ LoRA を会話形式でリアルタイム追加学習します。学習状態(教材ペア+最適化状態)を内蔵した llama.cpp 互換アダプタ GGUF を EXPORT ADAPTER で書き出し、モデル読込→アダプタ読込で再開できます。温度・推論時最大生成・文脈長を設定でき、Qwen3 では Think(思考出力)を評価用に無効化できます。
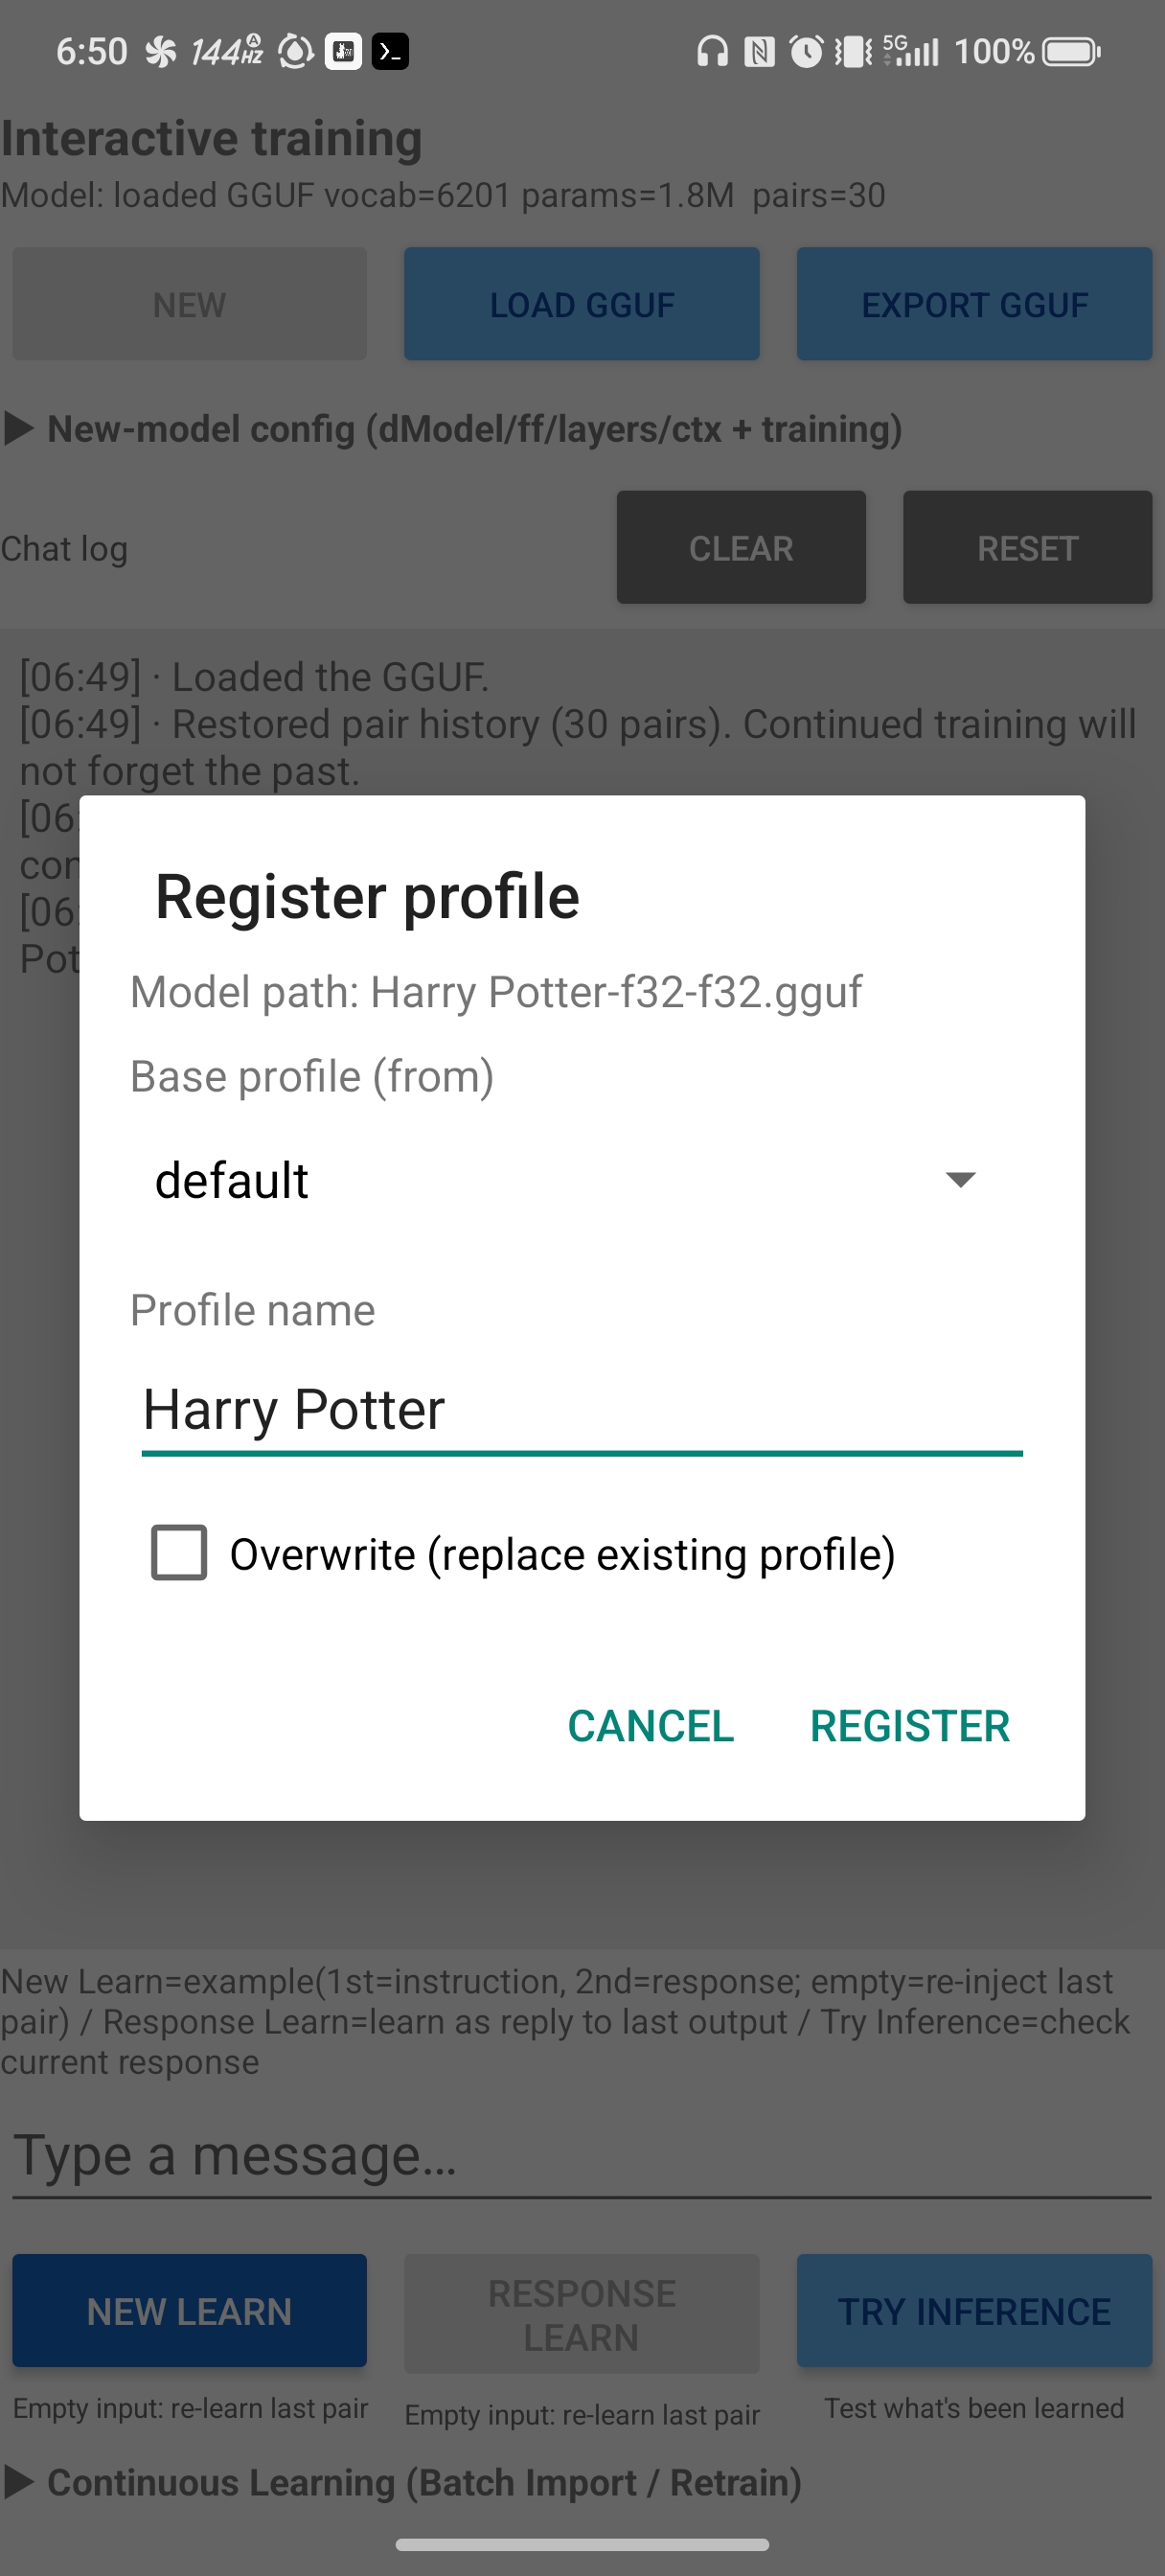
- プロファイル登録: 対話学習中に「Register Profile」ダイアログでロード済み GGUF に名前と基準プロファイルを設定して保存できます。複数の学習セッションを名前で管理し、設定を引き継いで再開できます。
- 量子化変換: 既存 GGUF を F32 / F16 / Q8_0 / Q6_K / Q5_K_M / Q5_1 / Q5_0 / Q4_K_M / Q4_1 / Q4_0 / Q2_K などの量子化形式に変換します。1-D テンソル(norm ゲイン)は精度保持のため F32 を維持し、行長が非ブロック境界のマトリクスは自動的に F16 にフォールバックします。「Strip retraining metadata」を有効にするとペア履歴・Adam 状態を除いた推論専用 GGUF を出力でき、配布・サイズ削減に利用できます。
- ペア編集・生成: 表示中のペアリストを作業対象に、LLM へのプロンプト指示で「新規ペア追加」「選択ペアの編集」「選択を種にした派生追加」を行います。入力素材として指定 URL または Wikipedia 検索 1 件を付与でき、チェックによる複数選択・初期化・保存に対応。保存したペアは対話学習の追加学習へファイル選択なしで渡せます(RAG 評価・Brave 検索は現在停止)。
- キーワード評価・早期停止: 手動キーワードまたはトークン自動抽出(surprisal 上位)による評価で、合格率が閾値に達したら学習を早期停止します(全学習モード共通)。
- Ollama 互換サーバ連携: 共通設定の LLM サーバ(既定
http://127.0.0.1:11434)へ接続し、/api/tagsでモデル取得、/api/generateで生成、/api/tokenizeでトークナイズを利用します。Web AI Chat でブラウザから直接チャットする機能も搭載します。 - Retrainable GGUF: アプリが出力する GGUF はそのまま再ロードして追加学習が可能です。詳細ページで仕組みと活用方法を解説しています。
- 端末内完結: 生成物(JSONL / GGUF)は端末の Downloads / Documents / アプリ領域へ保存します。トラッキングや解析情報の収集は行いません。
運用メモ
- ペア生成・編集は、利用者が設定した LLM サーバ(既定は端末内)や、Wikipedia・指定 URL への通信を伴います。送信内容・宛先は利用者の入力と操作に依存します。
- 端末内学習は CPU・メモリを多く使用します。長時間の学習では通知権限・電池最適化除外の許可が推奨されます。
- 量子化には次元制約があります(Q8_0 は 32 の倍数)。新規作成時のモデル寸法は自動で丸め・縮小されることがあります。