Android / llama.cpp / GGUF
LLM AI Server with llama.cpp
LLM AI Server with llama.cpp は、Android 端末上で GGUF モデルを読み込み、推論設定・プロンプトテンプレート・共有 MCP / Function Definitions 設定・ログ確認・Ollama/OpenAI/Anthropic 互換 API と同梱 WebUI の公開までを一つのアプリで扱えるローカル LLM 検証ツールです。
文書: 操作マニュアル | API リファレンス | 技術仕様 | llama.cpp / JNI / CMake 深掘り | プライバシーポリシー
- モデル URL からのダウンロードと、端末内
.ggufファイルの取り込み、LoRA アダプタ(スケール 0.3〜1.0)の適用に対応します。 - 生成パラメータ、Think 設定、カスタム chat template、共有 MCP 設定、Function Definitions JSON を組み合わせて運用できます。
- Ollama/OpenAI/Anthropic/Gemini 互換 API と WebUI を同じポートで起動できます。
/swaggerの Swagger UI で全エンドポイントを確認でき、CORS のオン/オフを Settings で切り替えられます。
スクリーンショット
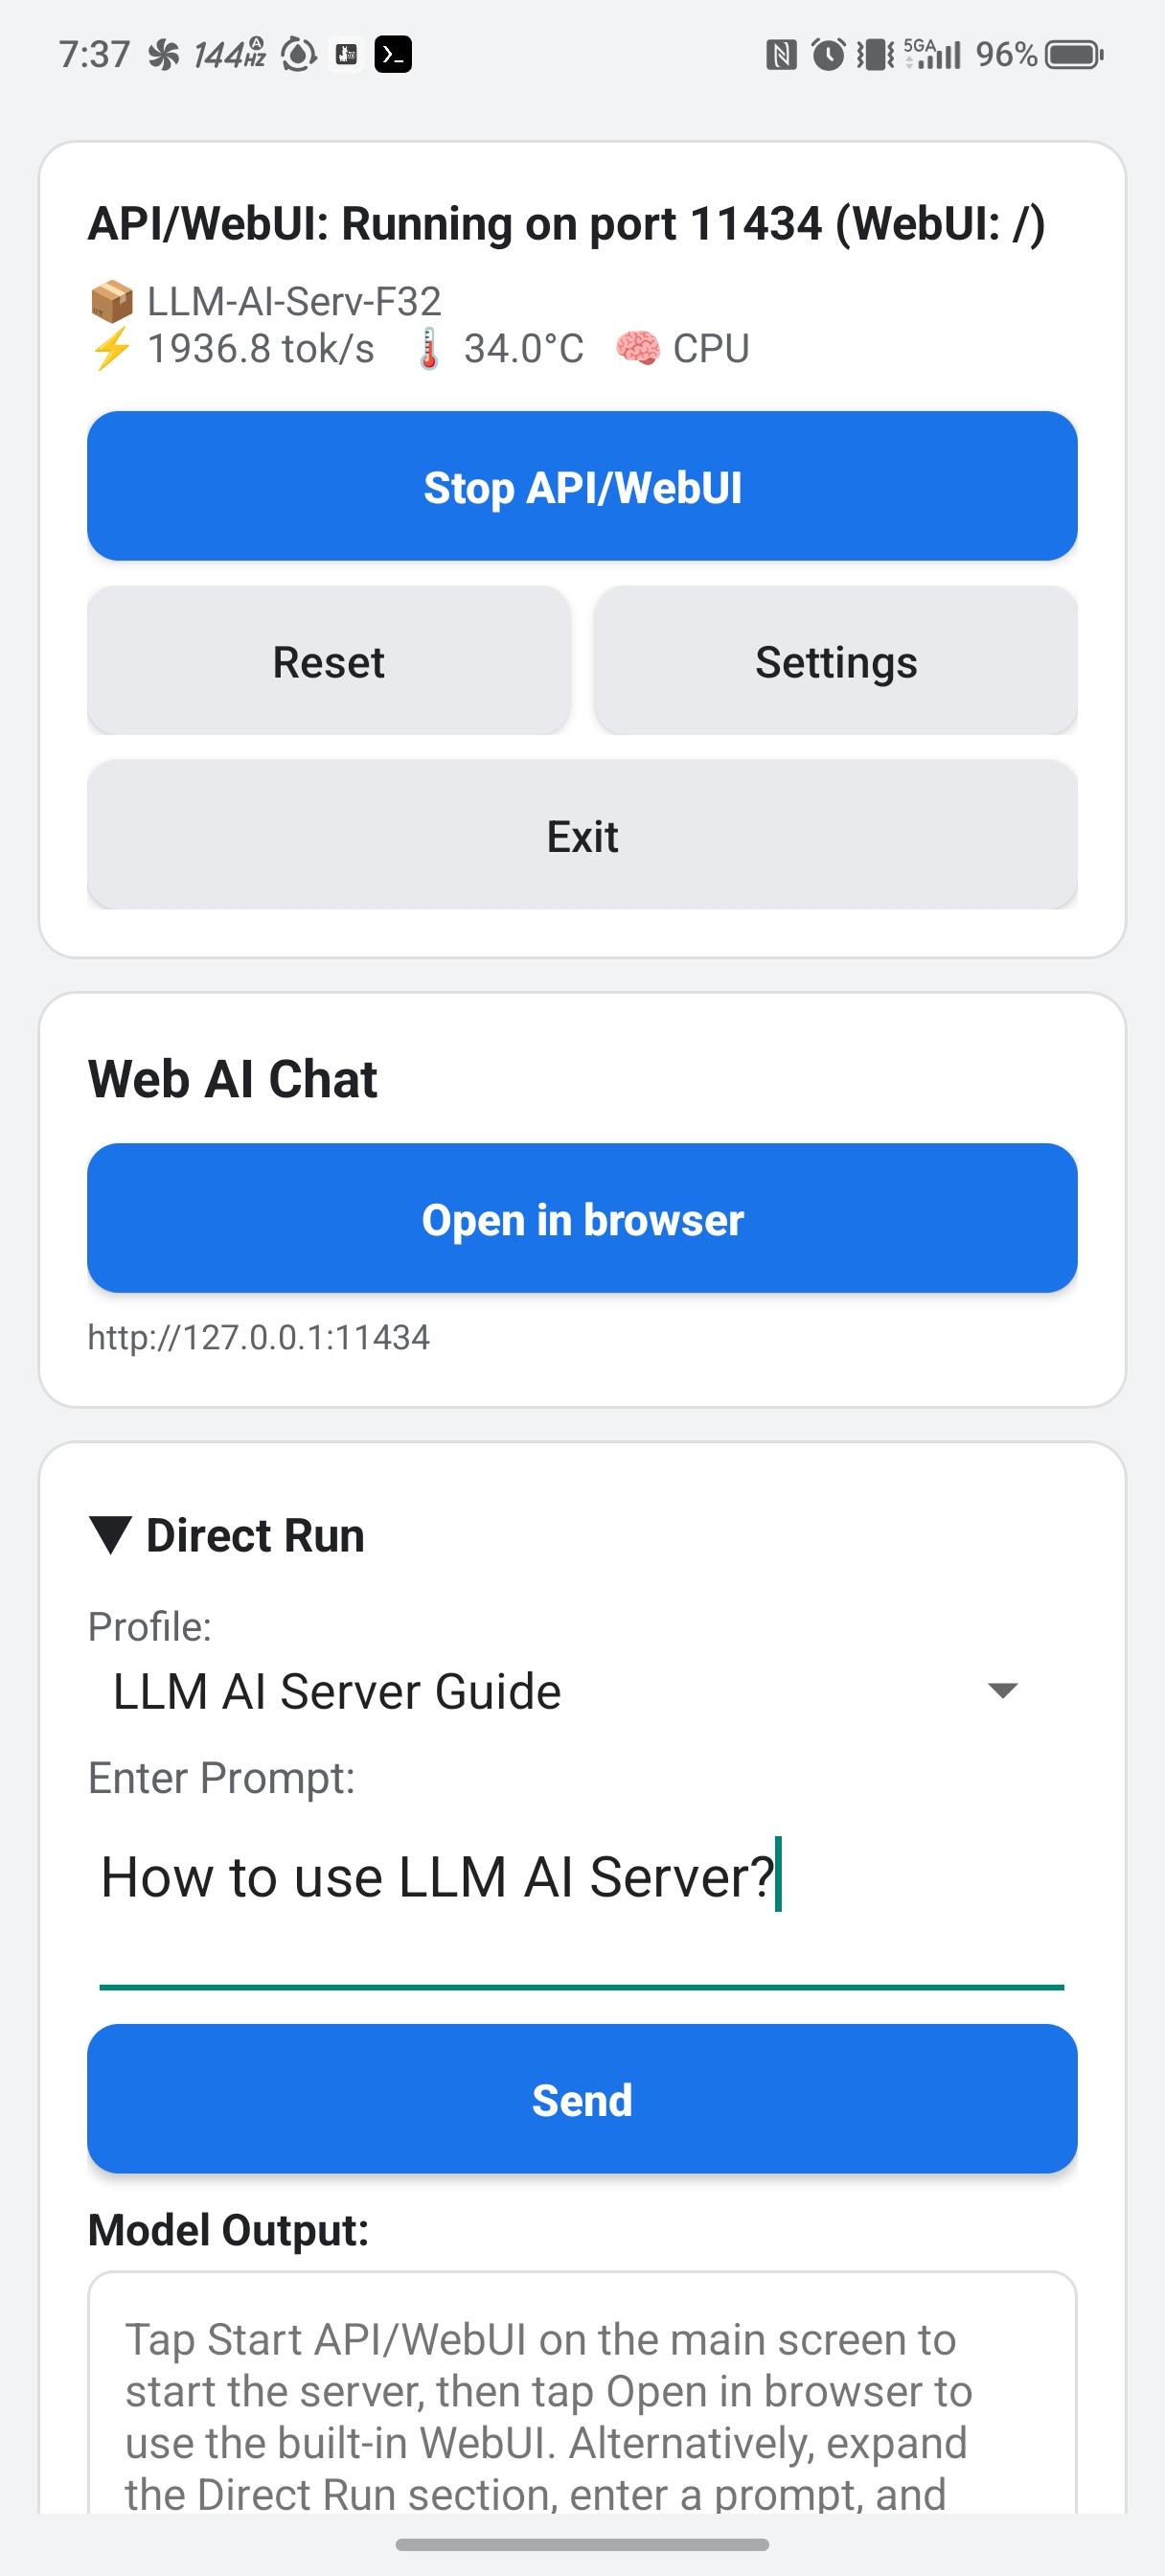
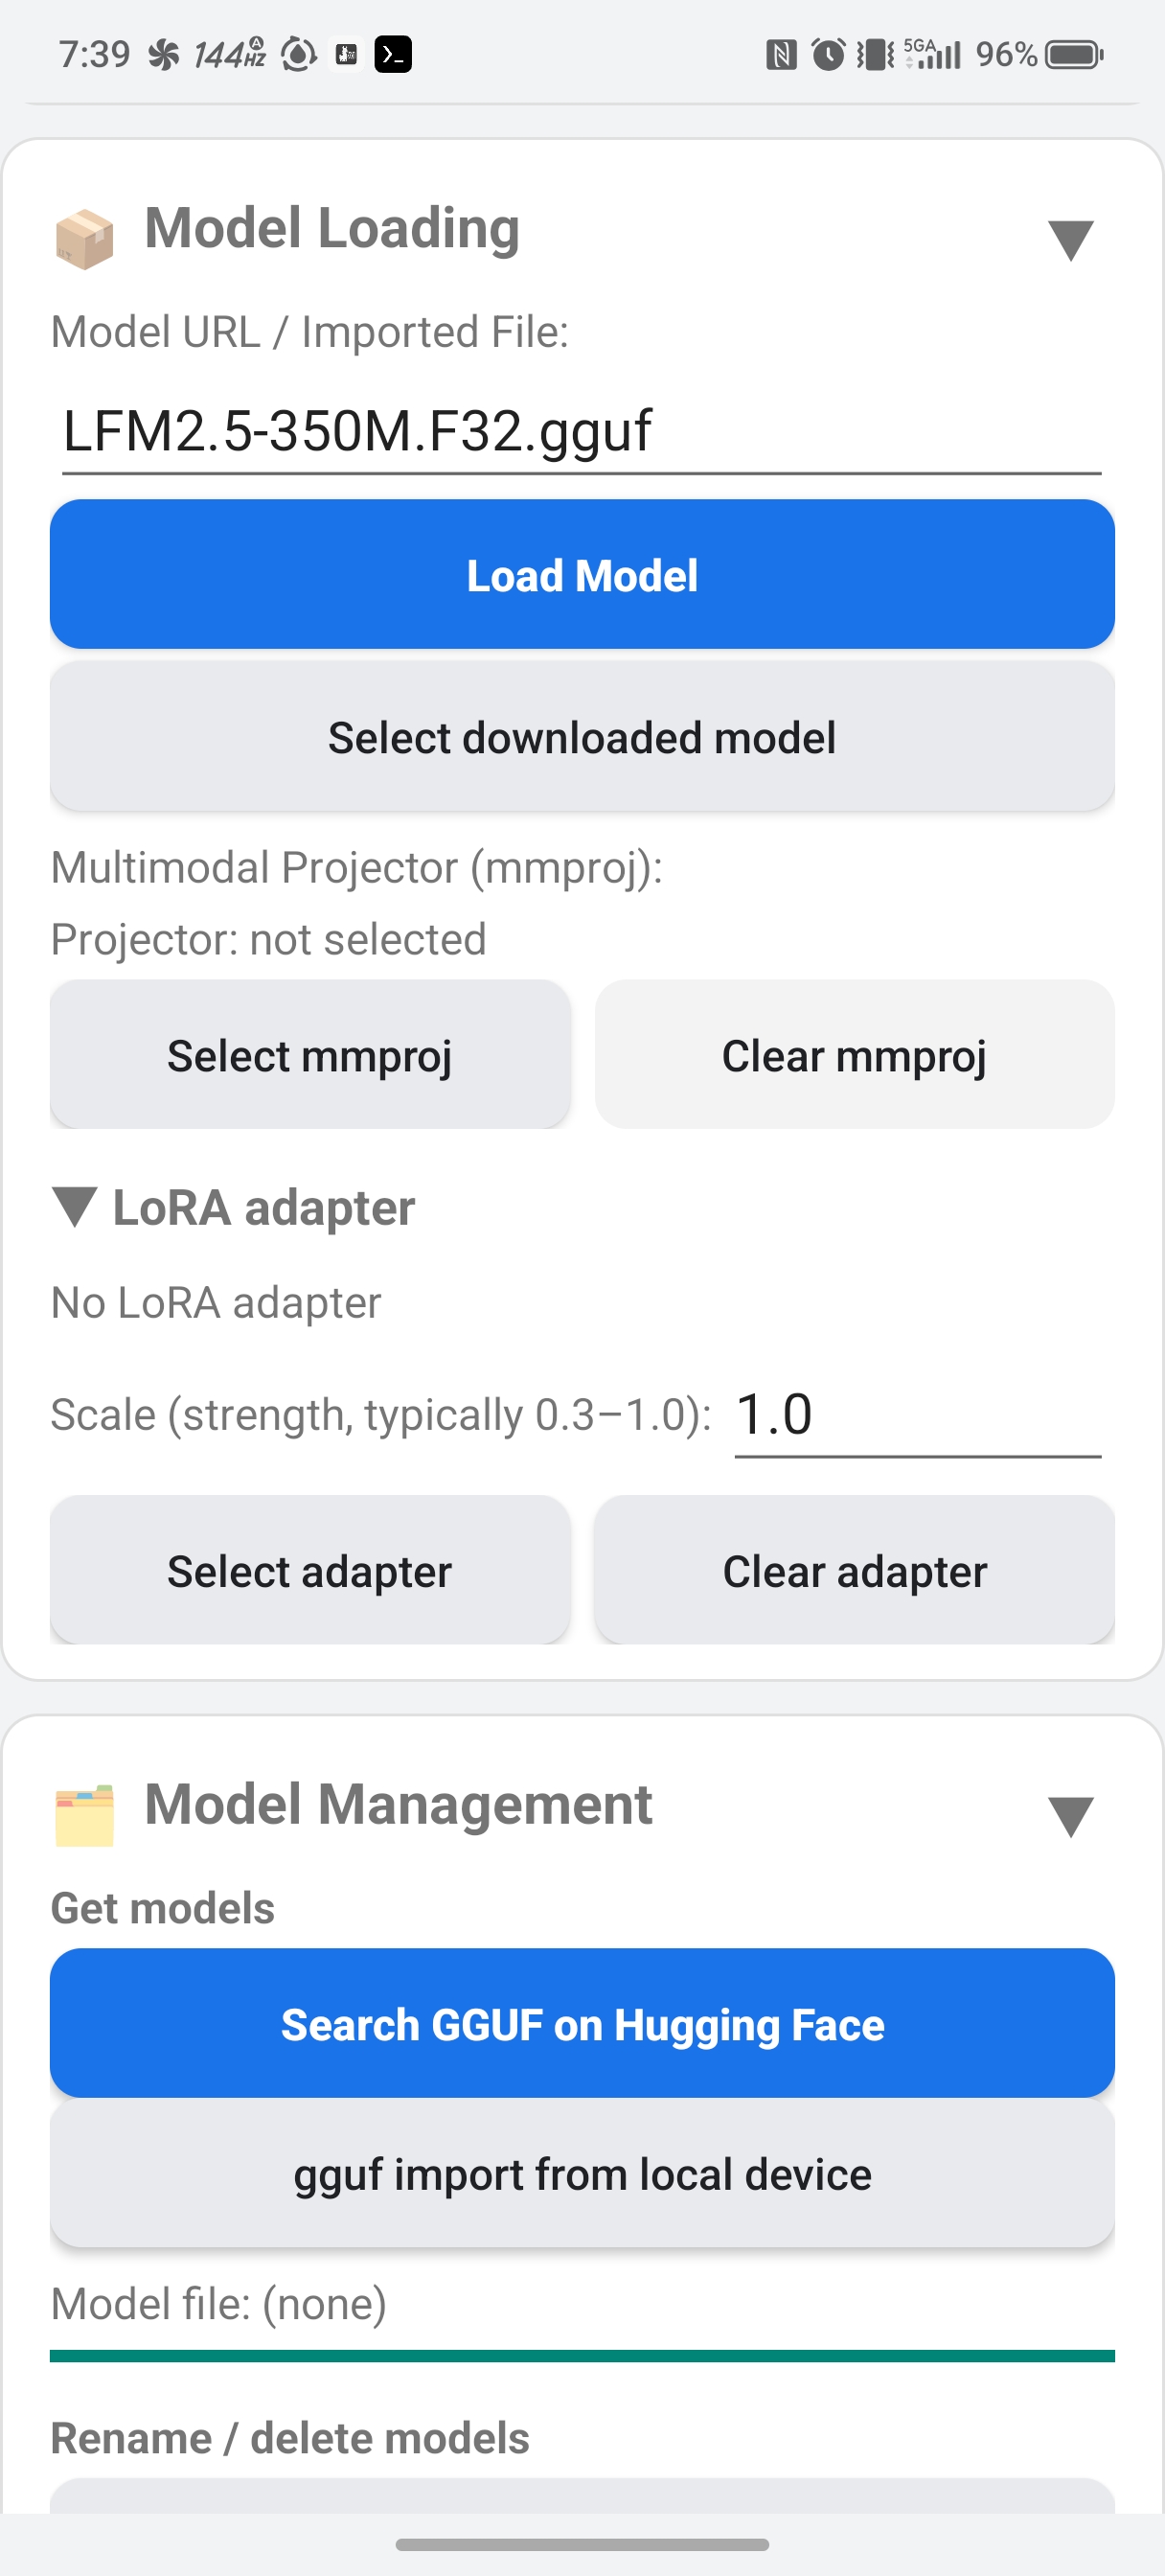
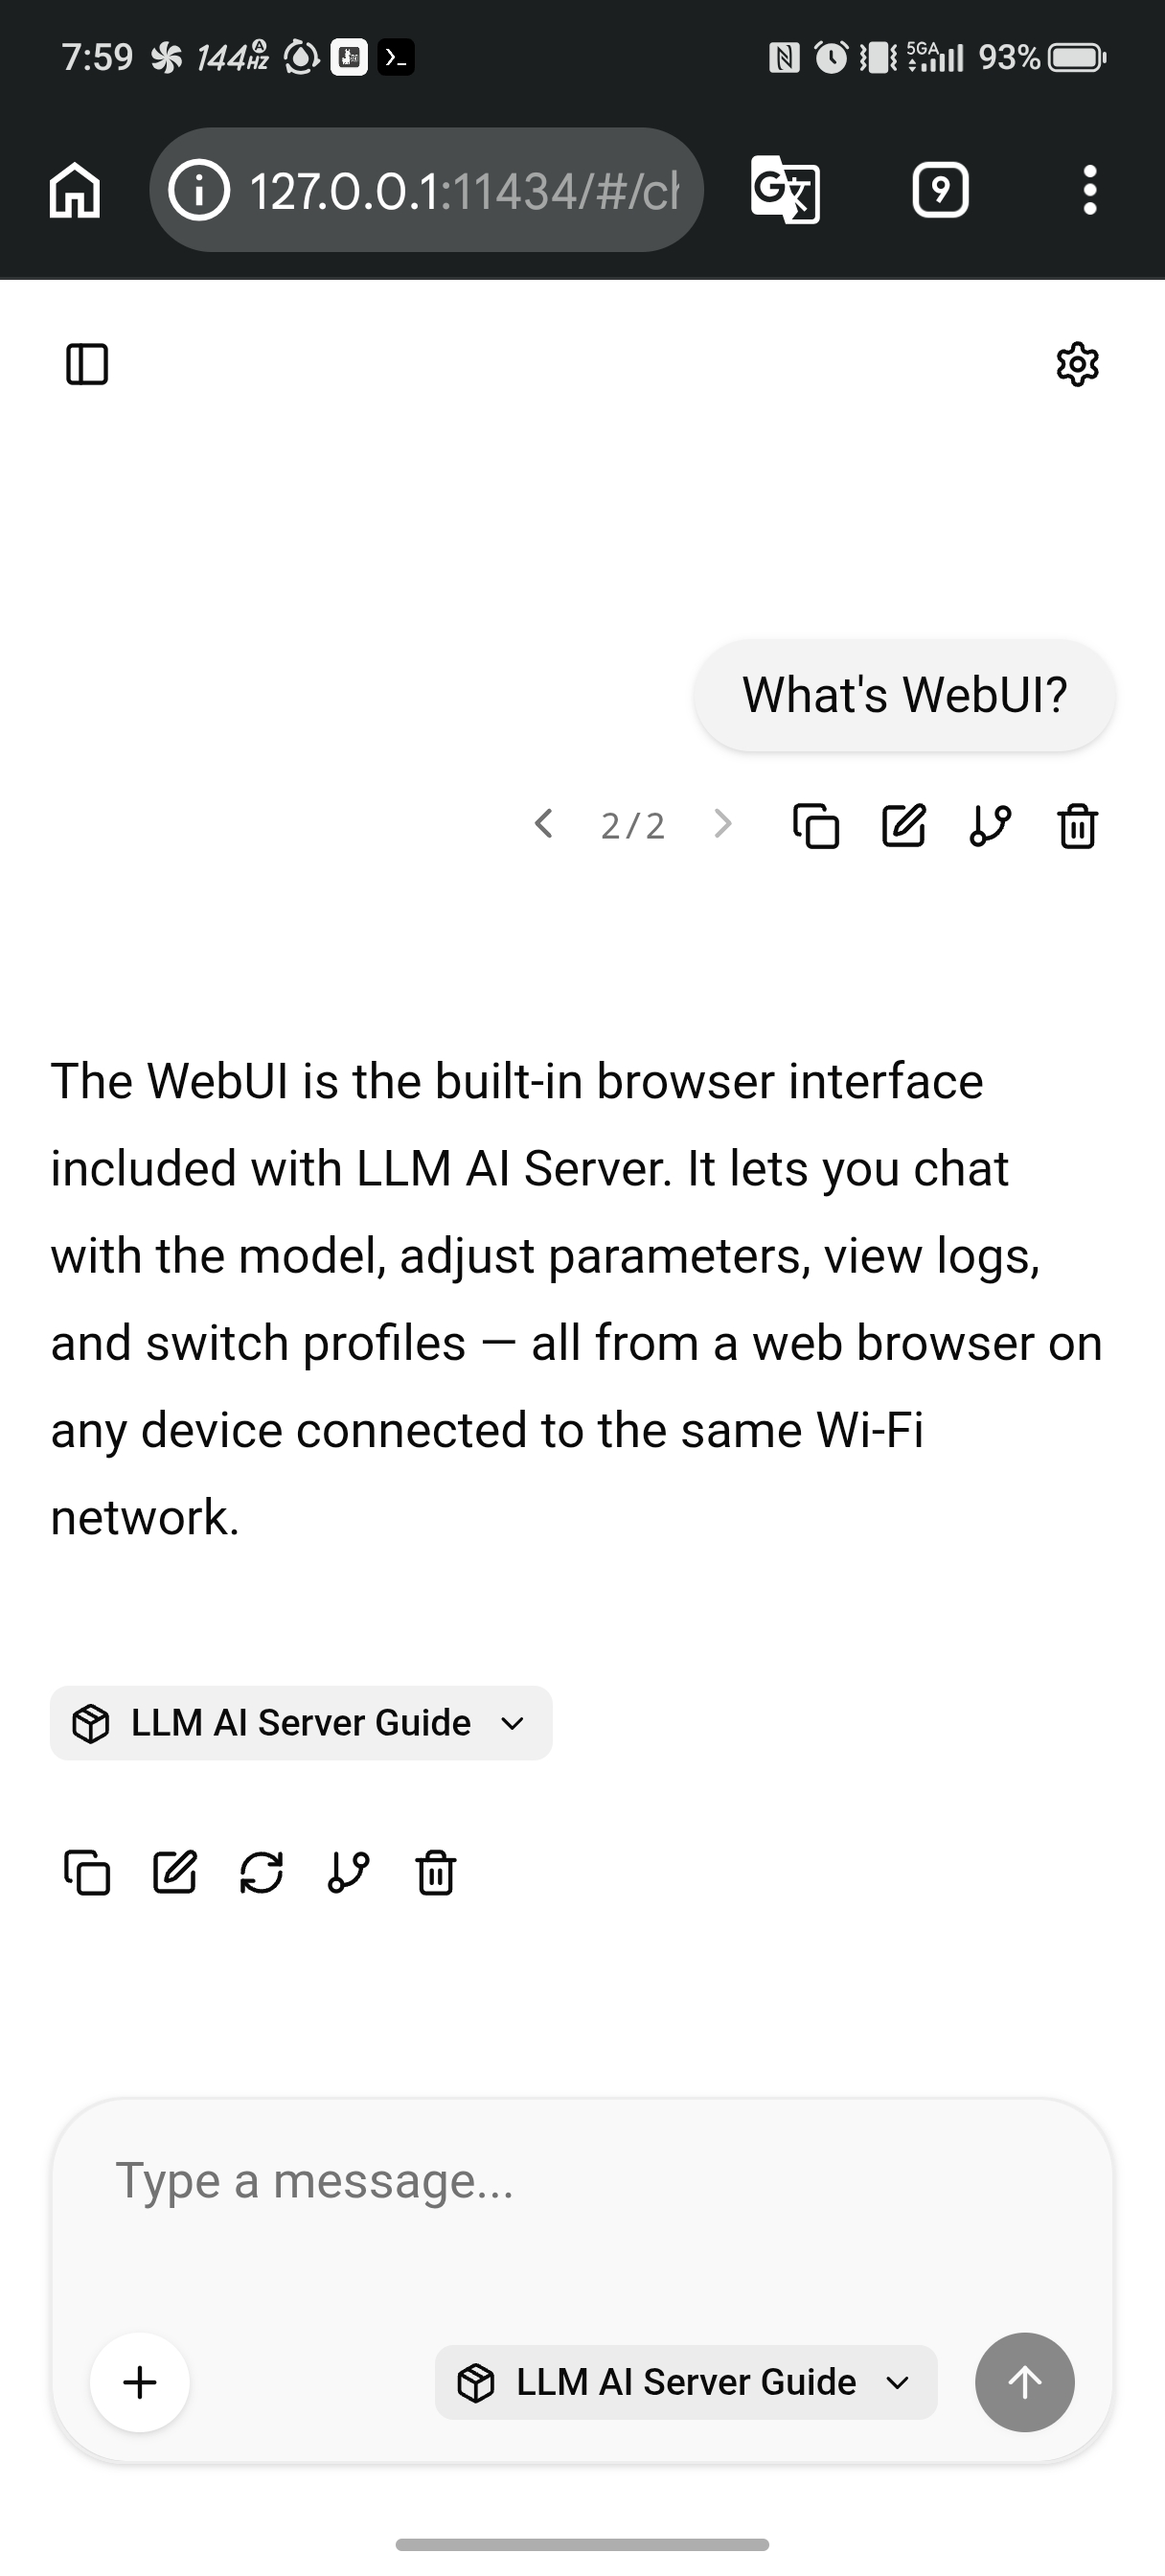
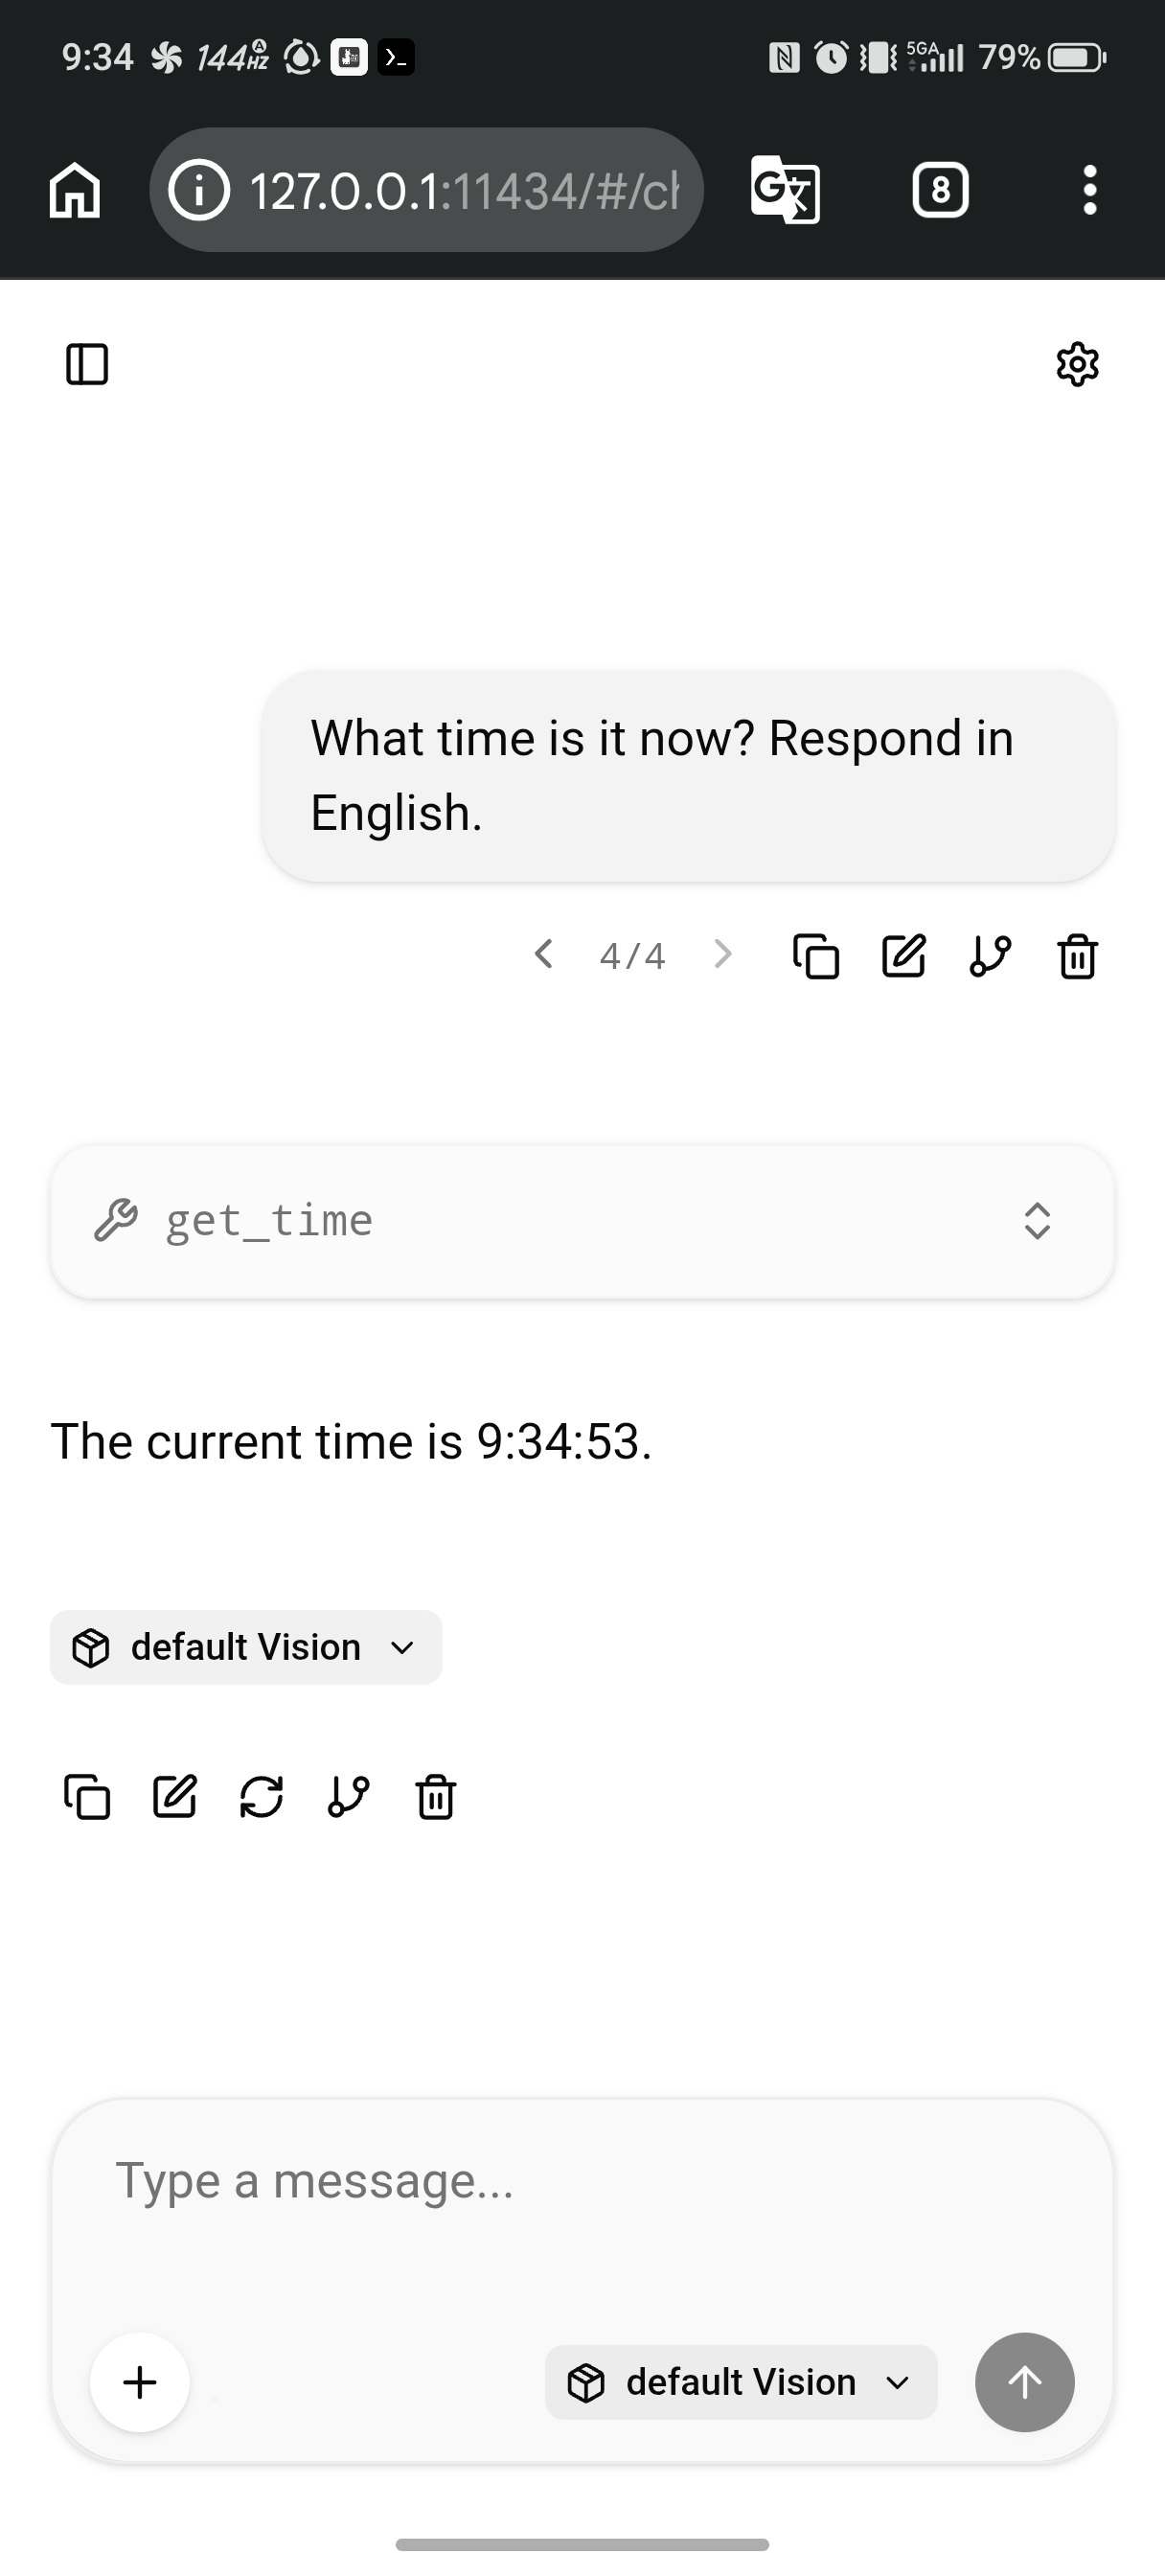
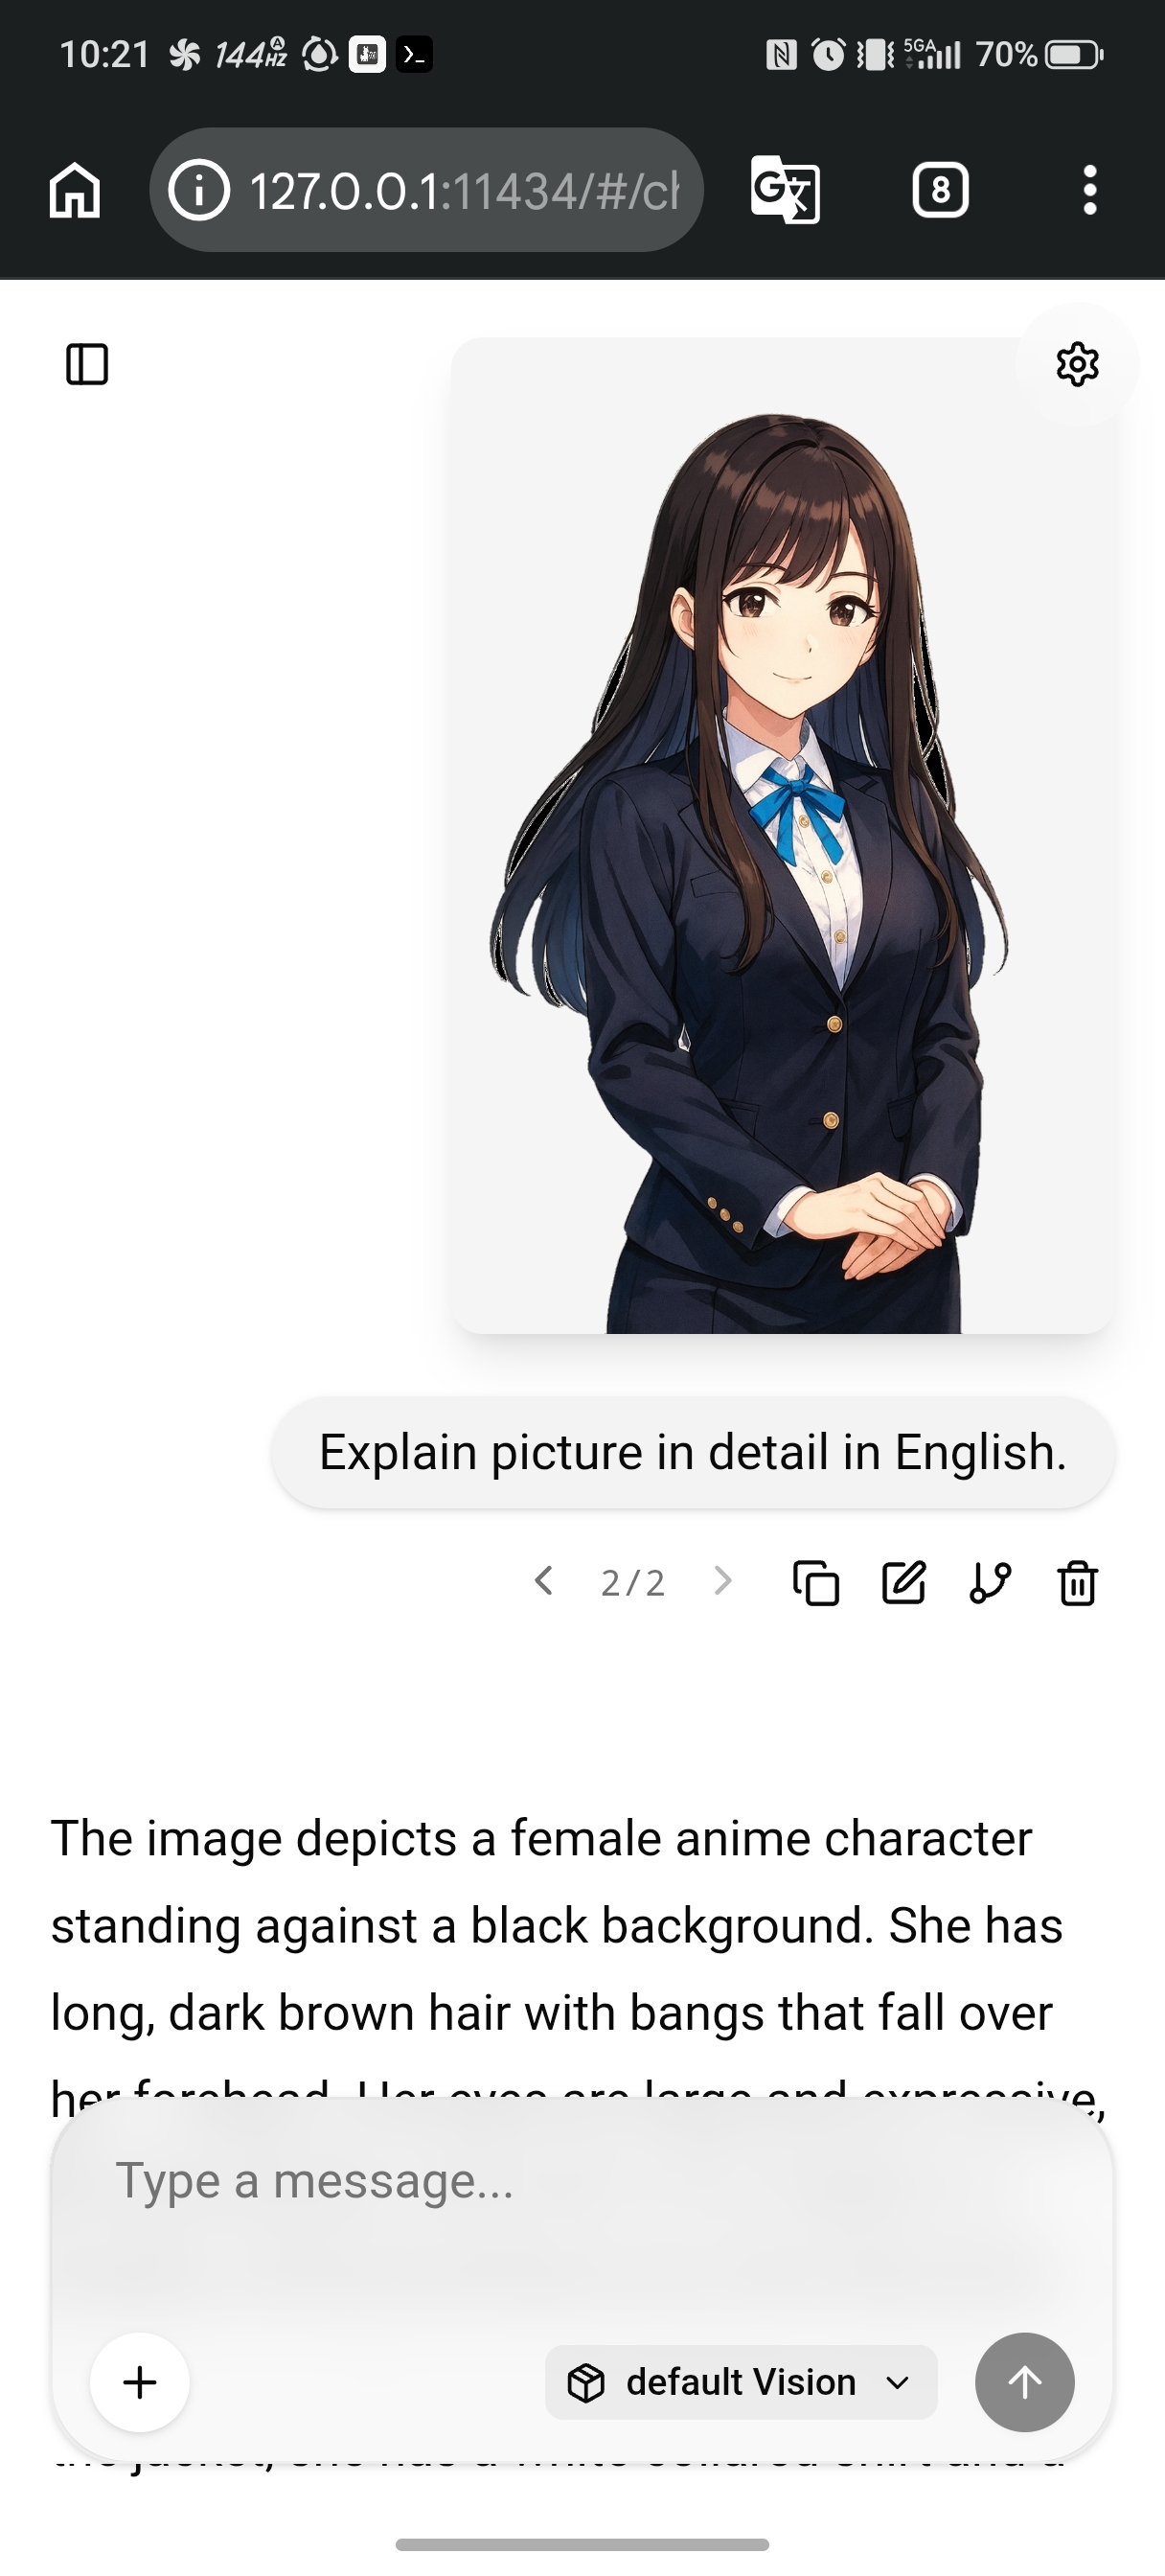
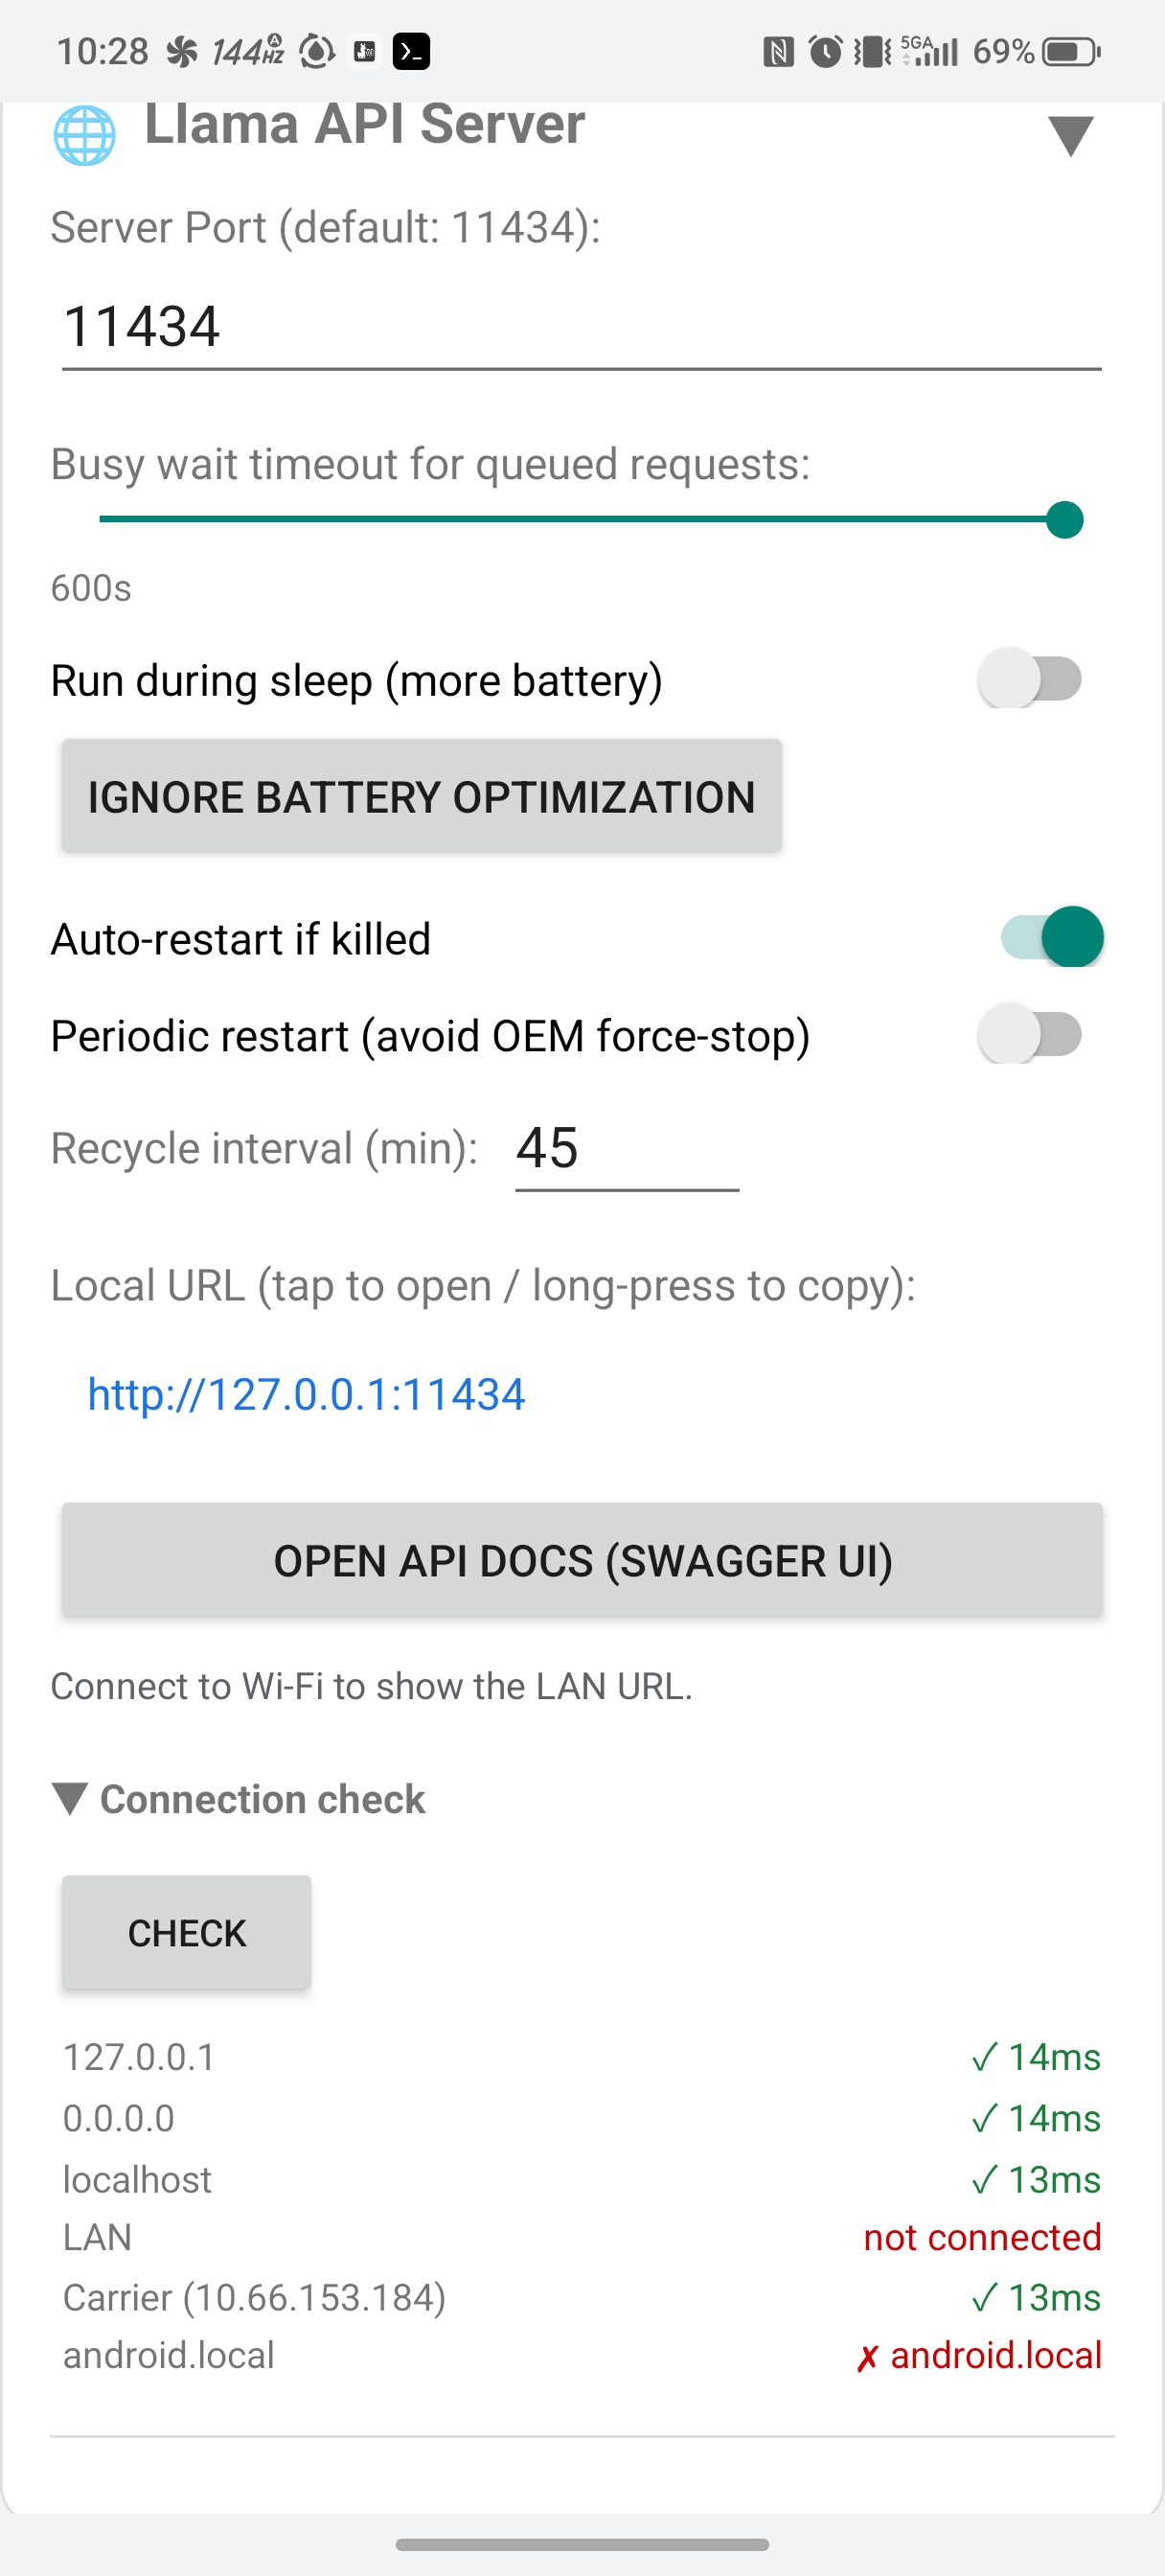
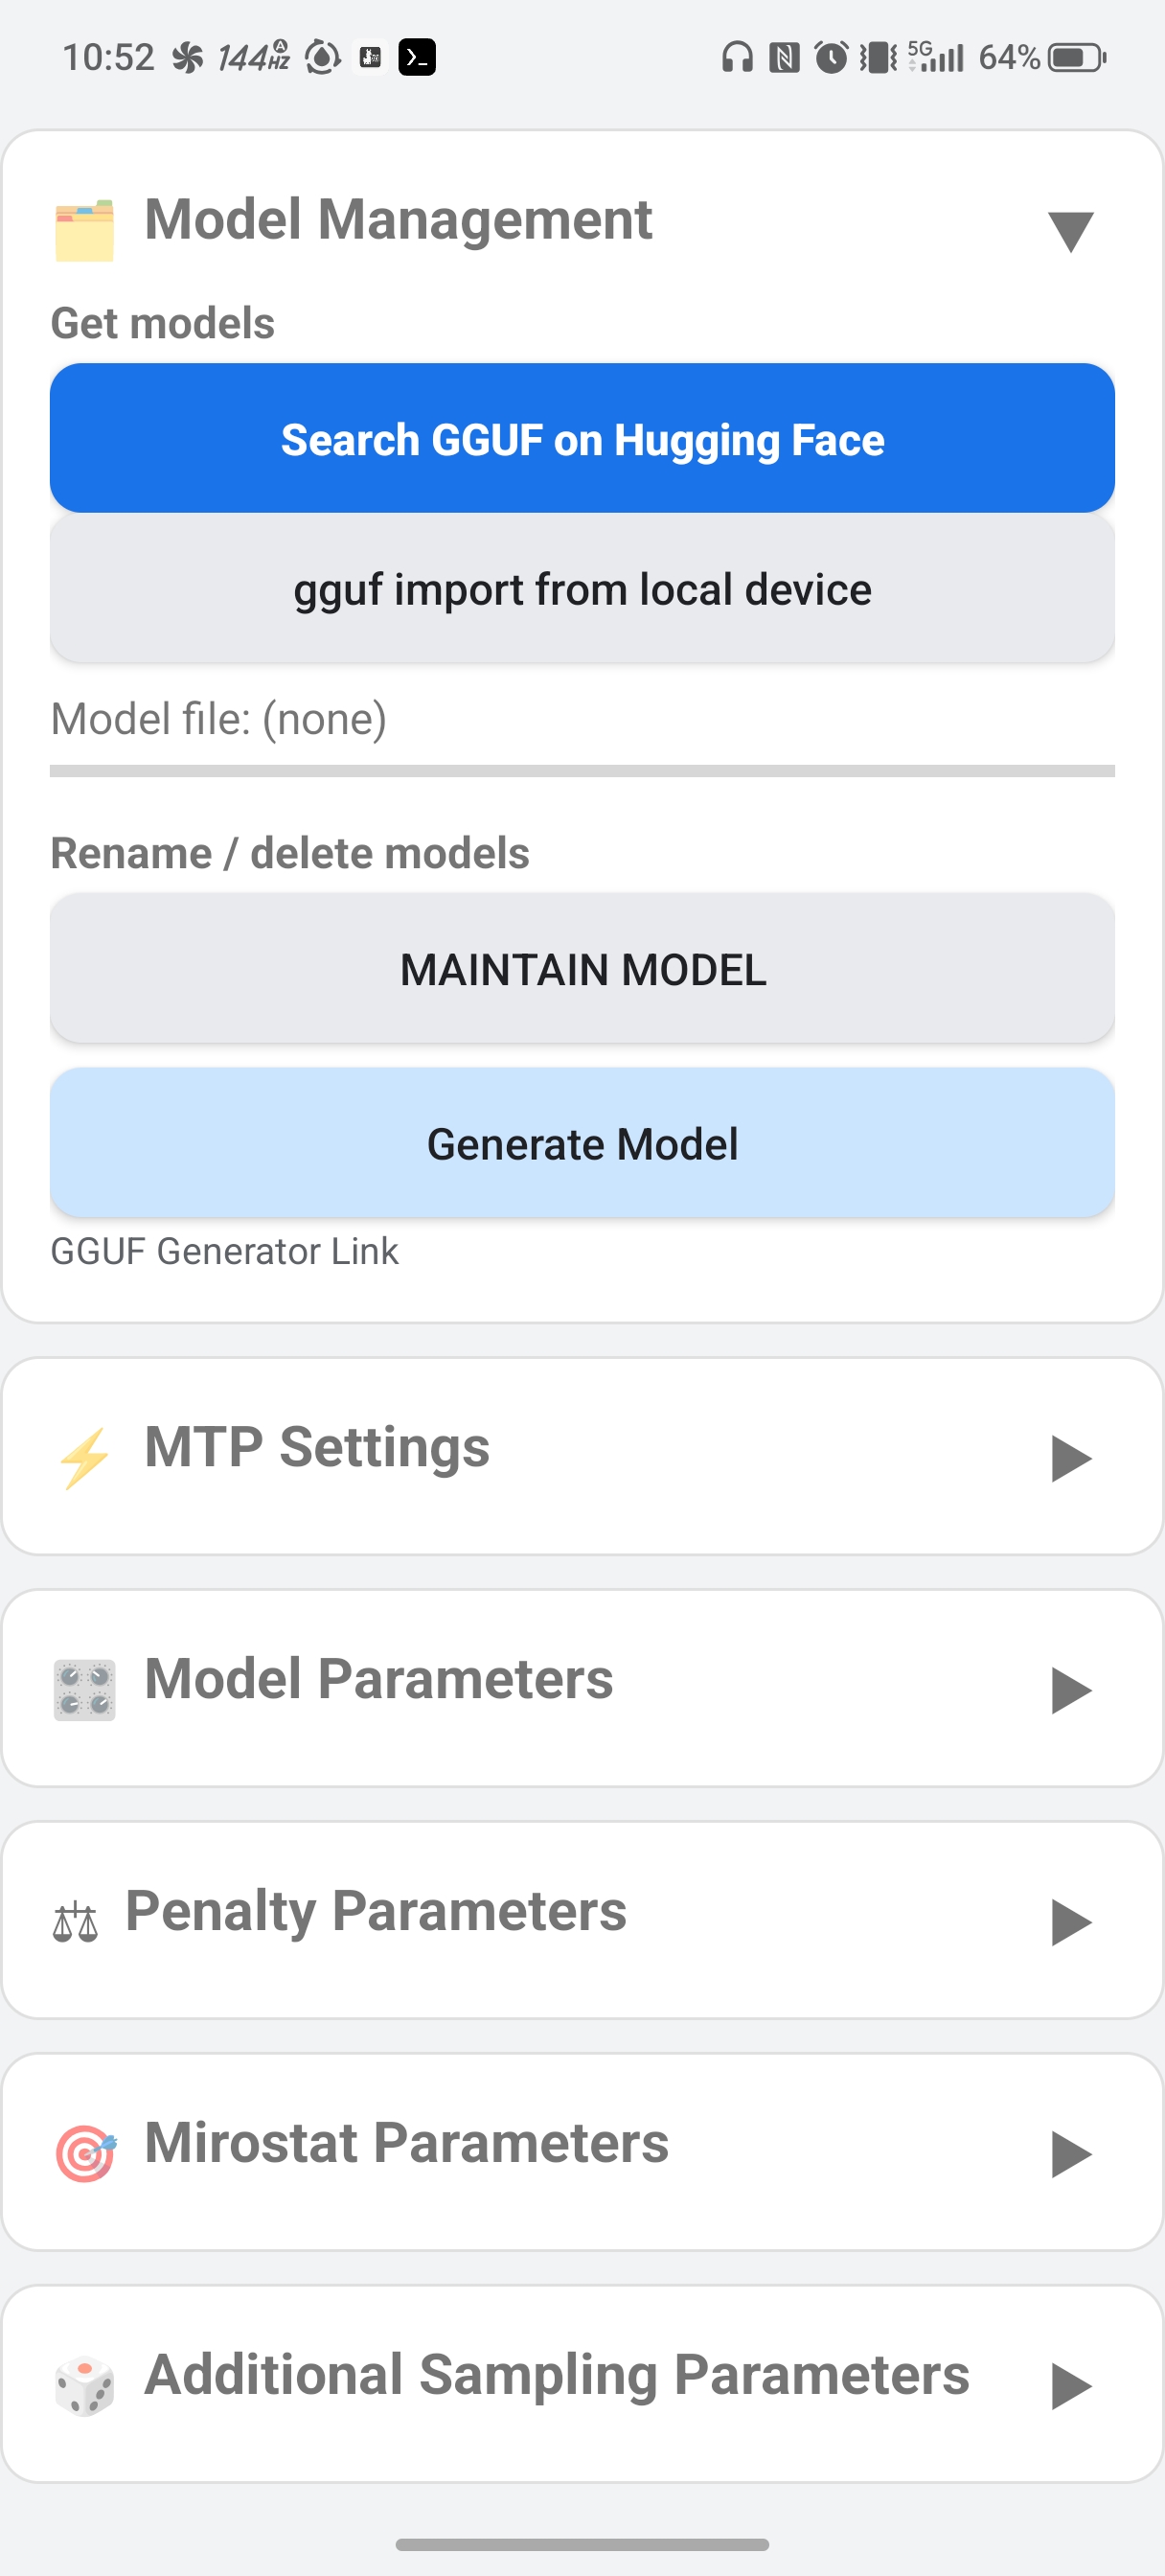
主な特徴
- 端末内でのローカル推論: llama.cpp を使って Android 端末上で GGUF モデルを直接実行します。
- モデル導入の自由度: HTTP/HTTPS のモデル URL 指定と、ローカル端末からの
.gguf取り込みの両方に対応します。LoRA アダプタ(.gguf形式)もモデルとは独立して選択でき、スケール(強度 0.3〜1.0)を調整して適用できます。mmproj(マルチモーダルプロジェクタ)の管理も同一画面で行えます。 - プロファイル説明とカードピッカー: 各プロファイルに説明文を設定でき、メイン画面のプロファイル選択がカード形式ダイアログに変わりました。名前と説明を並べて確認しながら切り替えられます。既存プロファイルにはアップグレード後の初回起動時にバンドルアセットの説明が自動補完されます。
- 詳細な推論制御:
n_ctx、n_threads、コンピュートバックエンド(CPU / GPU)、オフロード層数、Top-p、Top-k、Penalty、Mirostat、DRY、Think、custom chat template まで調整できます。 - ビジョン & コンテキスト自動拡張: 既定のビジョンモデルは Qwen3-VL。画像や長いプロンプトが
n_ctxを超える場合は端末メモリの範囲でn_ctxを自動拡張して読み込み直し、収まらない場合は API に明確なサーバーエラーを返します。GPU 初期化に失敗した場合は自動的に CPU へフォールバックします。 - モデル検索の強化: アプリ内の Hugging Face 検索で、モデル名・パラメータ数・量子化をプルダウンで絞り込み(各項目に一言ガイド)、端末に対する適合度レーティングを表示し、mmproj(Projector)ファイルを直接ダウンロードできます。
- 推論エンジン更新: llama.cpp b10621 (v0.3.0) / ggml 0.22 に更新。新しいモデルへの対応と Adreno OpenCL GPU を利用できます。
- MTP 投機デコード(実験的): MTP ヘッドを内蔵するモデル(Qwen3.5-MTP, Gemma 4 など)で MTP(投機デコード, draft-mtp)をモデル別プロファイルで有効化できます。既定 OFF、
n_draft調整可、追加ファイル不要(自ヘッド使用)。対応環境では生成が高速化する場合があります。 - 共有 MCP / Function Calling 設定: モデル別プロファイルとは別に MCP Config JSON と Function Definitions JSON を保存でき、外部利用スイッチを有効にするとメイン画面、
/api/chat、/api/generate、/v1/chat/completionsでも共通利用されます。 - 内蔵 Ollama/OpenAI/Anthropic/Gemini 互換 API と WebUI:
/api/chat、/api/generate、/api/tags、/api/diagnostics、/v1/chat/completions、/v1/completions、/v1/messages、/v1/messages/count_tokens、/v1/responses(OpenAI Responses API)、/v1/models、/props、/slots、/v1beta/models/{model}:generateContent(Gemini 互換)を同じポートで提供します。/swaggerの Swagger UI で全エンドポイントを対話的に確認でき、Settings の CORS トグルで外部アクセスを制御できます。同時生成は 1 件、待機キューは最大 10 件・既定最大 600 秒(設定で変更可)です。 - Anthropic Messages API 互換:
/v1/messages(ストリーミングは名前付き SSE イベント)と/v1/messages/count_tokensを提供し、system・マルチターン・thinking ブロック・画像/音声入力・基本的な tool_use / tool_result に対応します。Anthropic 公式 SDK の base URL をこのサーバーに向けて利用できます。 - 埋め込み・トークン数・モデル制御:
/api/embed、/api/embeddings、/v1/embeddingsで埋め込みベクトルを、/api/tokenize、/v1/responses/input_tokensでトークン数を取得でき、/models/load・/models/unloadでモデルの常駐を制御できます。 - 構造化出力とトークン統計:
format/grammar/response_format(JSON Schema・GBNF)で出力を制約でき、Ollama 形式のeval_count系と OpenAI 形式のusageを返すため既存クライアントがそのまま動作します。 - マルチモーダル API 入力:
/api/chat・/v1/chat/completionsのimage_url/input_audio、および/v1/messagesのimage/audioブロックで画像・音声を扱え、mmproj 対応モデルのロード状況に応じて利用できます。
運用メモ
- 大きなモデルの取得には数 GB 単位の通信が必要になる場合があります。モデルのダウンロードは Wi-Fi 環境が推奨です。
- ローカル API サーバーは同一端末またはローカルネットワーク向けの利用を想定しています。Android 13 以降では通知権限が必要になる場合があります。
- MCP サーバーを設定してメイン画面、API、または WebUI から利用する場合、会話内容やツール入力の一部が設定先 MCP サーバーへ送信されることがあります。